2018年8月5日星期日

当我们在谈论 AI 作画:风格迁移

引言

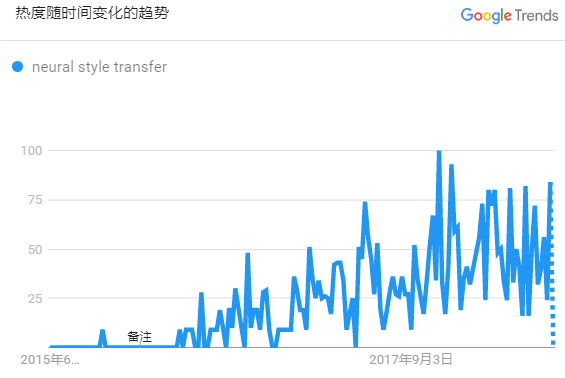
"风格迁移"相信大家都不陌生,最常见的形式就是将一张普通的图片转换为各种艺术风格图片。"风格迁移"本身并不是新课题,但是借助 Deep Learning 其效果大幅提升,变得实用起来。从 Google Trends 可以看到,其热度从2015年末开始一路攀升,甚至出现了火爆的"风格迁移"滤镜 app——Prisma。下面,我们将通过几篇文章,简单回顾一下"风格迁移"的发展,并实践看看它们是否足够智能。
Per-Image-Per-Model

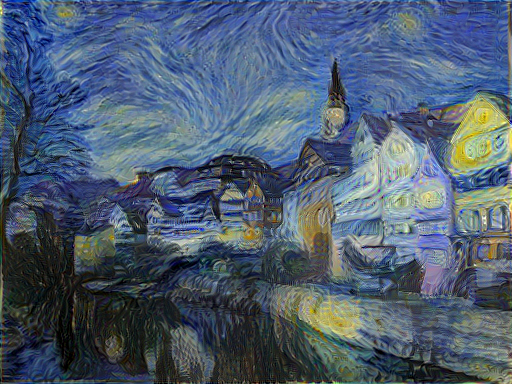
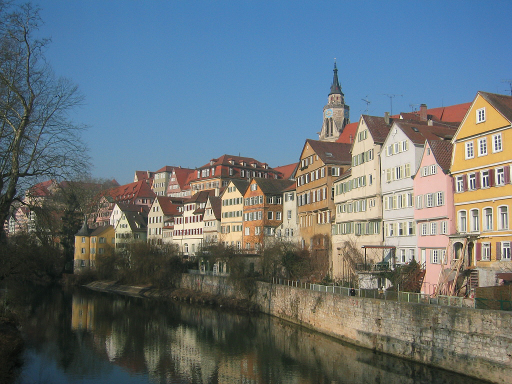
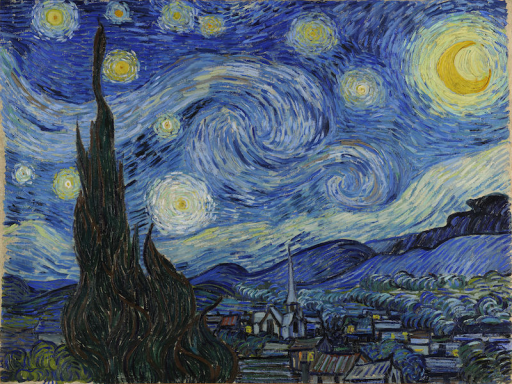
让我们回到2015年,由 CNN 带动起的这一波 AI 浪潮还在如火如荼的进行着:各种基于 CNN 的更强大的架构还在不停地被提出、ILSVRC 的屠榜活动也完全没有减弱的迹象、所有人都觉得这次智能时代真的要到来了。这一块的详细介绍可以参考"当我们在谈论 Deep Learning:CNN 其常见架构(上)"、"当我们在谈论 Deep Learning:CNN 其常见架构(下)"两篇文章,在这里先略过。在这种全民屠榜的时代,也会出现一些"不务正业"的学者,比如 Leon A. Gatys。 Gatys 在"A neural algorithm of artistic style.2015"提出了一种新技术:利用 CNN 来将一张普通图片转换成艺术画,如下图。他可能不曾想到的是,这项技术会发展出一个百亿市值的app——Prisma,这是后话了。我们先来介绍下这篇有趣的文章。
基本思路

事实上,文章的做法非常朴素:

  1. Loss 定义:由于希望输出图片保留着 Content Image 的内容以及 Style Image 的风格,作者定义了两种 Los:Content Reconstruction Loss、Style Reconstruction Loss。它们分别对应着输出图片与 Content Image 内容上的差异,以及与 Style Image 在风格上的差异。最终的 Loss 为两种 Loss 的加权和,权重用于调节希望更倾向于内容相似,抑或是风格相似
  2. 输入及输出:输入为高斯噪声图像, 通过不断改变输入图像的像素值来优化 Loss,最终得到的图像即输出结果
  3. 优化方法:万能的 Gradient Descent,即通过 BP 来优化输出图像的像素值,当 Loss 稳定时停止迭代

接下来,我们详细介绍下网络结构,与 Loss 的具体定义。

网络结构

作者使用的是训练好(Pre-Train)的 VGG-19 网络。VGG 网络源自"Very Deep Convolutional Networks for Large-Scale Image Recognition. 2014.",原文中被用于图片识别。由于训练好的 CNN 可以看成是对图像特征提取器(类比基于规则的特征提取),因此 Pre-Train VGG 也经常被用于提取图片特征。这里作者使用的是 VGG-19,其网络由大量 3*3 Convolution Layer(stride=1) 和 2*2 Max-Pooling Layer(stride=2)组合而成,其结构示意图如图:
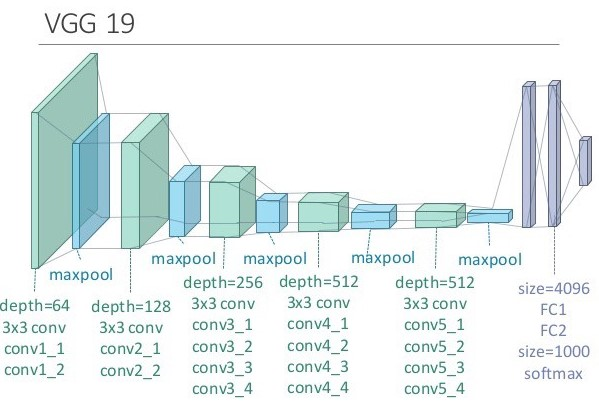
当然,作者在调参的过程中对 VGG-19 结构也做了些细微改变,这些调参细节这里不再赘述。

Loss 定义

Content Loss

如上面所说,由于希望输出图片保留着 Content Image 的内容以及 Style Image 的风格,作者定义了两种 Loss:Content Reconstruction Loss 和 Style Reconstruction Loss。我们先明确一下定义, x 表示输入图像, p 表示输出图像, l 表示 VGG 中的第 l 层。对于 VGG 第 l 层,假设有 N_l 个 filter,每个 filter 输出的 feature map 大小为 M_l (feature map 的长宽积)。这时,第 l 层的 layer 输出的 N_l 个大小为 M_l feature map,用一个 N_l*M_l 的矩阵 F^l 来记录。 F^l_{ij} 表示第 l 层,第 i 个 feature map 的第 j 个 activation 的值。

于是 Content Reconstruction Loss 可以表示为

L_{content}(p,x,l)=1/2 \sum_{i,j} (F_{ij}^l - P_{ij}^l)^2

Style Loss

比较有趣的是 Style Reconstruction Loss,作者创造性的以第 lN_l 个 feature map 之间的 Gram Matrix 作为它们风格描述。Gram Matrix 的定义如下
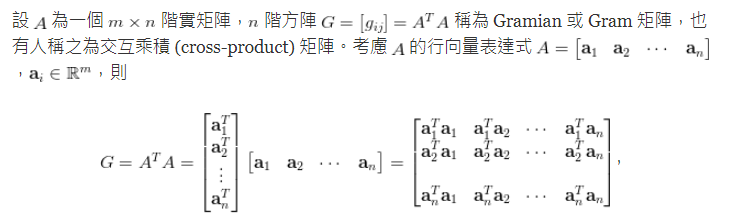
在本文中,上图的 A^T 就是第 l 层 layer 中的矩阵 F^l。若令 a,x 分别表示输入图像、输出图像, A^l,G^l 分别为它们第 l 层的风格描述,则第 l 层的 Loss E_l 定义为

E _ { l } = \frac { 1 } { 4 N _ { l } ^ { 2 } M _ { l } ^ { 2 } } \sum _ { i , j } \left( G _ { i j } ^ { l } - A _ { i j } ^ { l } \right) ^ { 2 }

多 Layer 的总 Style Reconstruction Loss 则可以表示为

\mathcal { L } _ { s t y l e } ( a , x ) = \sum _ { l = 0 } ^ { L } w _ { l } E _ { l }

相信不少同学跟我一样,对 Gram Matrix 为什么能够作为风格描述比较疑惑。事实作者在文中也没有解释,但在Quora中有同学提到过 Gatys 在其他场合有过解释,虽然我并没有找到原始出处(因此无法保证真实性),还是放在这里供大家参考

"Gatys when asked why gram matrix at a talk said that the Gram matrix encodes second order statistics of the set of filters. it sort of mushes up all the features at a given layer, tossing spatial information in favor of a measure of how the different features are correlated." - Siraj Raval

如果觉得上述定性理解并不令人信服的同学,还可以查看"Demystifying Neural Style Transfer"这篇文章,作者从优化的角度对 Gram Matrix 的有效性进行了解读。

Total Loss

有了上述 Content Loss、Style Loss,Total Loss 的定义也就呼之欲出了。令 p,a,x 分别表示 Content Image、 Style Image、以及输出图像,则 Total Loss 定义为

\mathcal { L } _ { t o t a l } ( p,a,x ) = \alpha \mathcal { L } _ { c o n t e n t } (p , x) + \beta \mathcal { L } _ { s t y l e } ( a, x )

效果测试

这里我们以两组图像为例,看看这篇文章的效果如何。

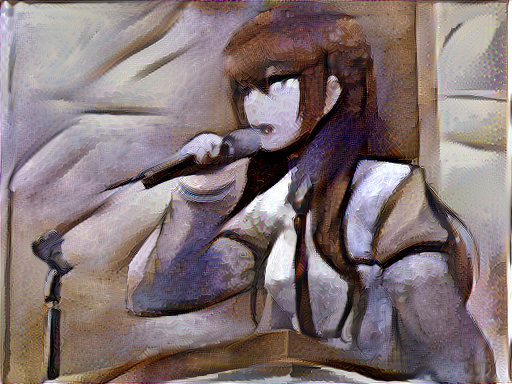
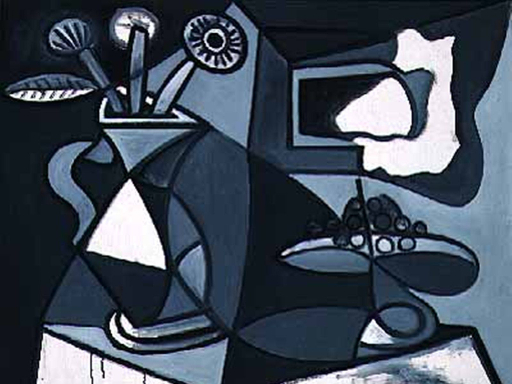
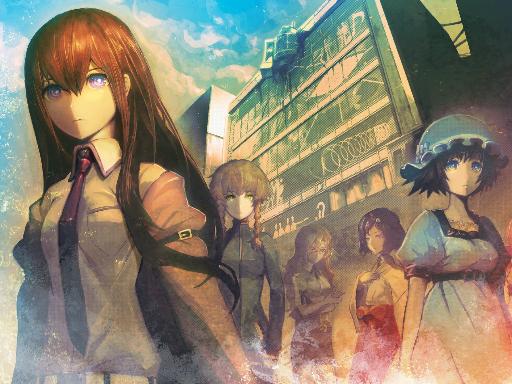
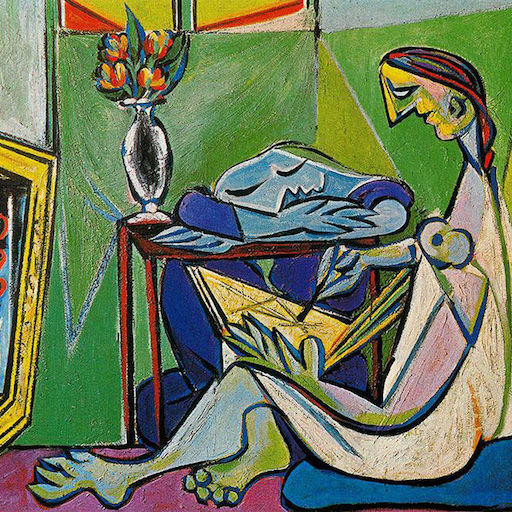
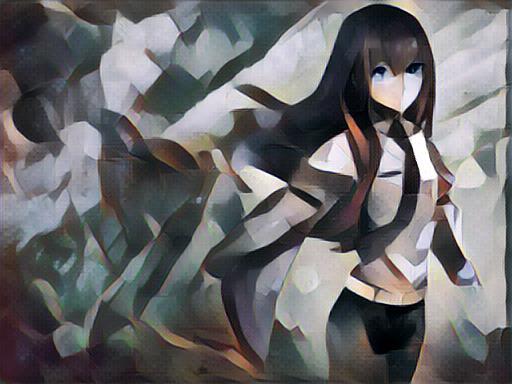
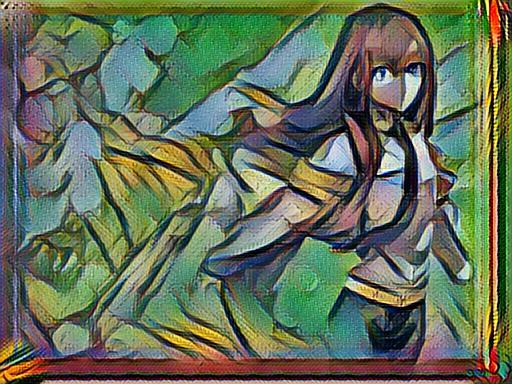
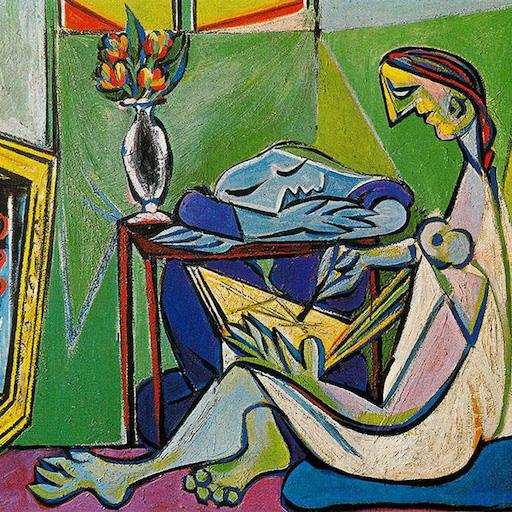
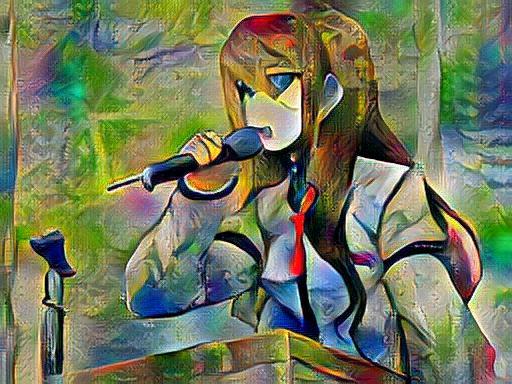
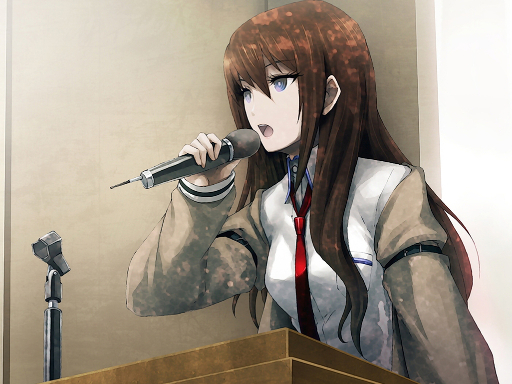
对于 AI 类实验,首先当然邀请我的 AI 女神 Makise Kurisu(牧濑红莉栖),就拿她那张发表演讲的照片作为 Content Image 吧!Style Image 就选择毕加索的这幅"Reclining Woman 1954",结果如下
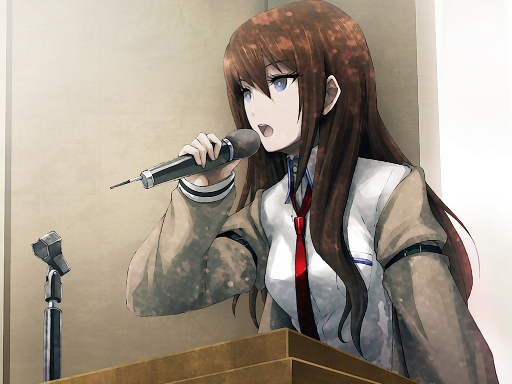
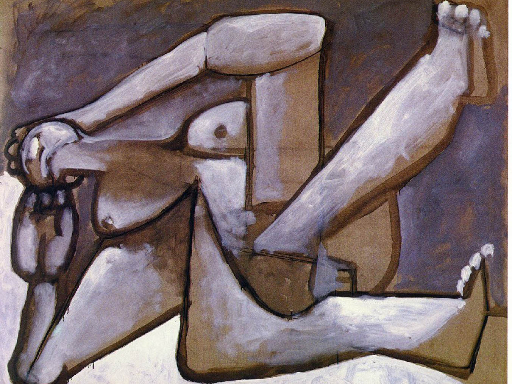
可以看出,得益于 Style Image 的风格较为简单,人物主体部分风格确实已经跟"Reclining Woman 1954"比较相似了,这里主要体现在颜色(近似)以及线条(较粗放)上。不过缺点也是有的,比如背景上多了一些莫名其妙的线条,以及 Kurisu 那怨念的眼神。。。

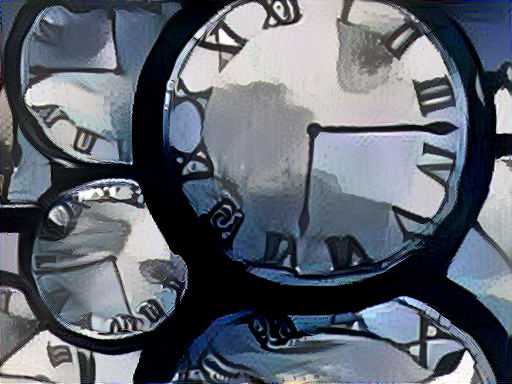
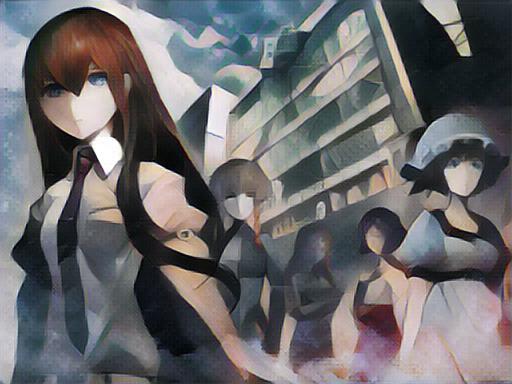
为了避免被女神揍,接下来我们再看一组静物的效果。
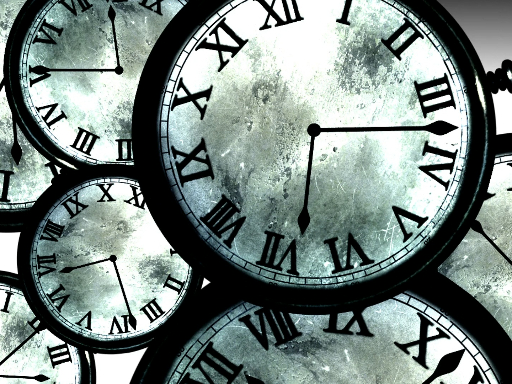
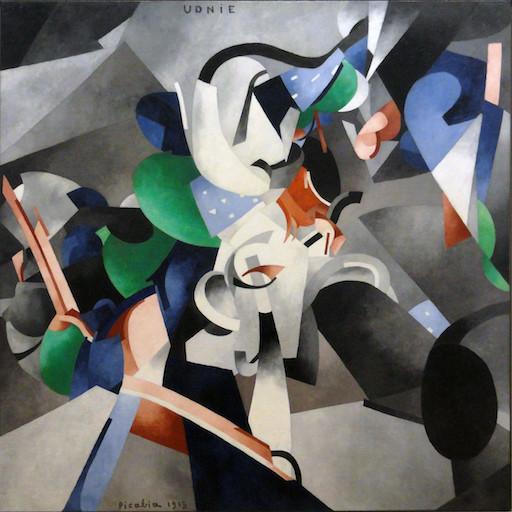
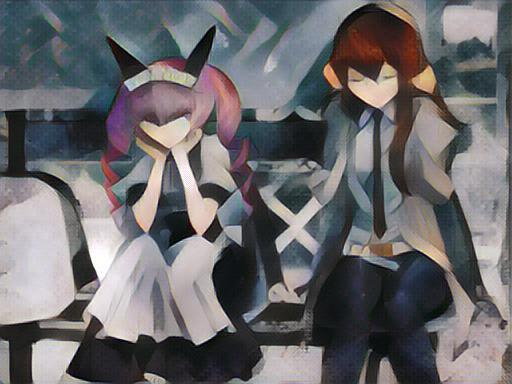
这一次, Style Image 几乎是由纯色块构成的,很少出现渐变色;而 Content Image 背景有一定复杂度(较多不规则污渍),且构图难以通过色块表达,为了向 Style Image 靠近,输出图像产生了一系列畸变。虽然效果并不算很好,但是我意外地喜欢这种畸变的效果!

所以,风格这种东西,存在一定的主观性,较难评价。作为 Neural Style Transfer 的开山鼻祖,它最大的意义在于率先开辟了这条有趣的道路。而它最大的缺点,就是实在是太慢了,对于每一组 Content Image 和 Style Image,永远都需要重新训练(好几个小时),这个代价是不可接受的。所以,大量后来者开始向这方面努力。

Per-Style-Per-Model

时间来到2016年,GoogLeNet、ResNet 等更强大的架构已经争先恐后地被提出来。虽然曾经的王者 VGG 才诞生才两年不到,这时候回头看它朴素地俨然上个世纪的产物。这时,"风格迁移"也已经不是新鲜事了,但如上文所述,Gatys 文章提出的方法速度实在太耗时了。借助如今更强大的网络架构,是否有可能在保持质量的情况下,提高"风格迁移"的速度呢?李飞飞团队成员 Johnson 的文章"Perceptual losses for real-time style transfer and super-resolution. 2016"正是希望缓解这个问题。

在此文章中,Johnson 提出了一个新的网络结构,同时用于解决"风格迁移"与"图像超分辨率"的问题,下面我们仅介绍与"风格迁移"相关的部分。

基本思路
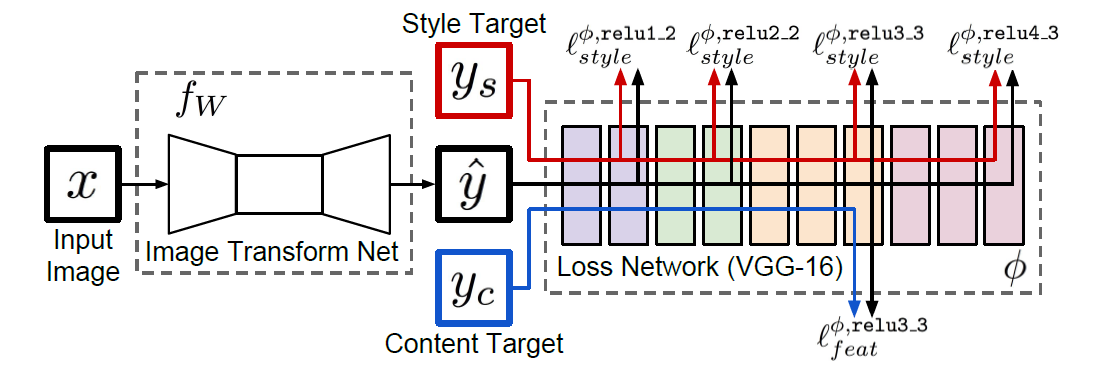
Johnson 提出的网络结构如上图,不同于 Gatys 文章中仅有一个网络(VGG-19),这里本质包含两个网络:图像的生成网络(Image Transform Net)与 Loss 计算网络(Loss Network)。基本思路如下:

1. 在训练阶段,输入为大量 Content Image 与一张 Style Image(因此一个模型只能训练出一种风格)。每次输入一张 Content Image 图像和一张 Style Image,这里将它们表示为 \left\{ y _ { i } \right\} 。对 Content Image x ,利用 Image Transform Net 进行"风格迁移"生成 f_W(x) ,并通过 Loss Network 计算 Loss(可能包含多个不同定义的 Loss, { \ell _ { 1 },..., \ell _ { k }} )。接下来通过 GD 优化下面的目标

W ^ { * } = \arg \min _ { W } \mathbf { E } _ { x , \left\{ y _ { i } \right\} } \left[ \sum _ { i = 1 } \lambda _ { i } \ell _ { i } \left( f _ { W } ( x ) , y _ { i } \right) \right]

2. 在测试阶段,将 Content Image 图像输入 Image Transform Net,输出 f_W(x) 则为"风格迁移"后的图像

3. 文章中 Loss 的定义与 Gatys 近似,也主要包含 Feature Reconstruction Loss.、Style Reconstruction Loss 两个方面,这在后面详细介绍

网络结构

Image Transform Net

Image Transform Net 的结构主要由 Convolution Layer 和 Residual Block 组成,具体如下表。
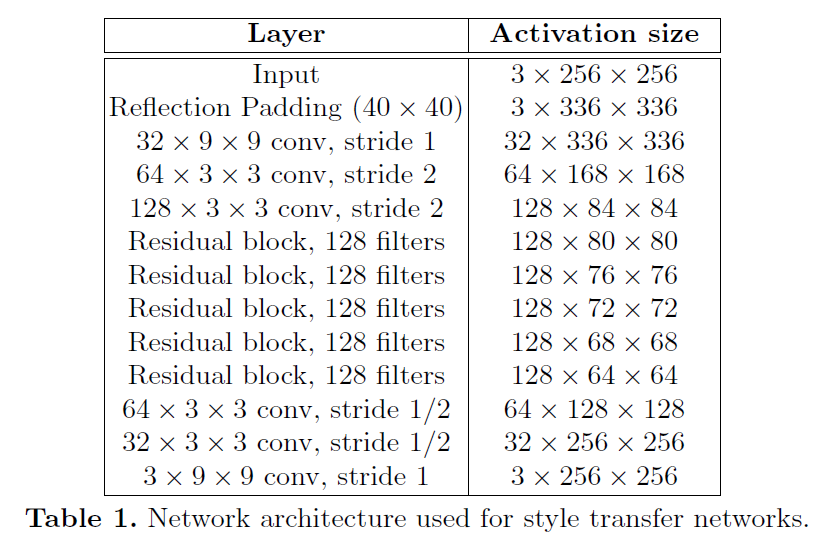
其中有几点需要说明:

  1. 作者为了减少计算量,同时也为了扩大 Convolution Kernel 能够影响的区域大小,通过对输入图像先进行下采样,再进行上采样的方式来获得原图大小的输出图像。关于下采样部分比较好理解,即上图中的两个 stride=2 的 Convolution Layer。对于上采样,作者使用了两个 stride= \frac{1}{2} 的 Convolution Layer,或者可以称作是 stride=2 的 Transposed Convolution Layer。Transposed Convolution 的概念非图像领域的同学可能比较陌生,可以参考"Transposed Convolution, Fractionally Strided Convolution or Deconvolution",我就不再对其定义赘述了。
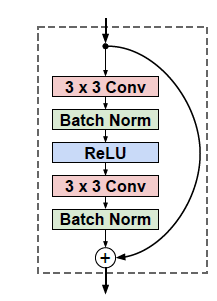
  2. 其时 RestNet 已经被提出(RestNet 的具体介绍可以参考"当我们在谈论 Deep Learning:CNN 其常见架构(下)"),Residual Block 已被证明在较深网络中更容易优化。同时对于"风格迁移"这类任务,输入图像与输出图像相似度比较高,"Residual Block 更易表达恒等变换"的性质也较为适用此种场景。本文所使用的 Residual Block 结构如下图
  3. 其他细节如采用了 Batch Normalization 来降低优化困难(Batch Normalization 的介绍与有点可以参考"当我们在谈论 Deep Learning:DNN 与它的参数们(叁)")等这里也不再详细描述。
Loss Network

Loss Network 其实就是 Pre-Trained VGG-16。按照文中的说法,VGG的 weight 在本实验中训练阶段也是固定的(测试阶段根本不会用上)。所以,这里可以认为 VGG 是一种固定的特征提取方式,方便计算 Feature Reconstruction Loss.、Style Reconstruction Loss。VGG-16 的具体结构这里就不再赘述了,详细可以参考"Very Deep Convolutional Networks for Large-Scale Image Recognition. Computer Science, 2014."。

Loss 定义

Feature Reconstruction Loss

\hat { y } 为 Image Transform Net 的输出图像, \phi 为 Loss Net(VGG-16),Content Image 为 y 。有 \phi _ { j } ( y ) 为 Content Image 在 Loss Net 中第 j 层的 activation,形状为 C _ { j } H _ { j } W _ { j } ,即 Channel、Height、Width。与 Gatys 文章的定义类似,Feature Reconstruction Loss 定义为某个 Convolutional Layer 中 y,\hat { y } 的差异,即

\ell _ { f e a t } ^ { \phi , j } ( \hat { y } , y ) = \frac { 1 } { C _ { j } H _ { j } W _ { j } } \left\| \phi _ { j } ( \hat { y } ) - \phi _ { j } ( y ) \right\| _ { 2 } ^ { 2 }

Style Reconstruction Loss

同样与 Gatys 文章的定义类似,每一层 Convolutional Layer 的风格使用不同 Channel 的 Feature Map 的 Gram Matrix 来描述,Style Reconstruction Loss 则定义为 Gram Matrix 的 F 范数,具体公式如下

\begin{align} & G _ { j } ^ { \phi } ( x ) _ { c , c ^ { \prime } } = \frac { 1 } { C _ { j } H _ { j } W _ { j } } \sum _ { h = 1 } ^ { H _ { j } } \sum _ { w = 1 } ^ { W _ { j } } \phi _ { j } ( x ) _ { h , w , c } \phi _ { j } ( x ) _ { h , w , c ^ { \prime }} \\ & \ell _ { s t y l e } ^ { \phi , j } ( \hat { y } , y ) = \left\| G _ { j } ^ { \phi } ( \hat { y } ) - G _ { j } ^ { \phi } ( y ) \right\| _ { F } ^ { 2 } \\ \end{align}

Total Variation Regularization

为了令输出图像平滑,作者还参考 "Understanding deep image representations by inverting them.2015."中的定义,为 Total Loss 增加了正则项。对于一个图像 xx _ { i j } 表示 i,j 坐标处的像素值,Total Variation Regularization 定义如下

{\ell}_ { TV } ( \mathbf { x } ) = \sum _ { i , j } \left( \left( x _ { i , j + 1 } - x _ { i j } \right) ^ { 2 } + \left( x _ { i + 1 , j } - x _ { i j } \right) ^ { 2 } \right) ^ { \frac {1 } { 2 } }

Total Loss

最终,Total Loss 的定义呼之欲出,即

\ell _ { total } = \lambda _ { c } \ell _ { f e a t } ^ { \phi , j } \left( y , y _ { c } \right) + \lambda _ { s } \ell _ { s t y l e } ^ { \phi , J } \left( y , y _ { s } \right) + \lambda _ { T V } \ell _ { T V } ( y )

其中 y, y_c, y_s 分别表示 Image Transform Net 的输出图像,Content Image,Style Image。 \ell _ { s t y l e } ^ { \phi , J } ( \hat { y } , y ) 表示多个 Layser 的 Style Reconstruction Loss 之和, J 表示 Layer 的集合。

效果测试

可以看出,此文章中训练好一种风格的 Model 后,当需要进行"风格迁移"时,仅需要进行 Forward Propagation 即可,速度优势非常明显。而且按照文章中的例子,其生成图像的质量与 Gatys 不相上下。这里我以几组照片看看它的具体效果。
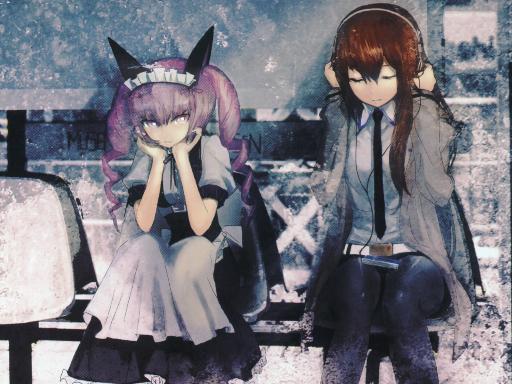
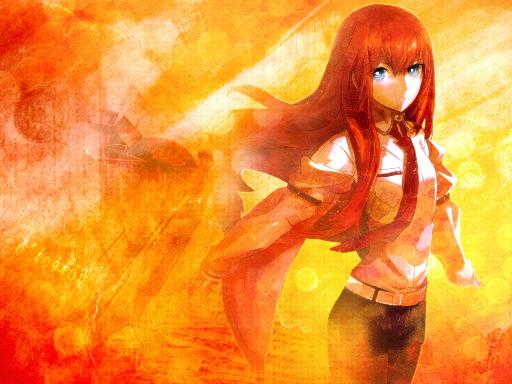
仅从上面这一组图上看,Johnson 提出的方案在细节保留的能力非常恐怖(尤其是结果1和3),其效果也几乎都是我期望的输出。不知道是否是得益于更多的训练数据,部分结果质量甚至超出我的预期,当然不排除是小数据下的巧合。但是不得不说,这样的结果已经让我有利用模型来生成壁纸的欲望了。

其他

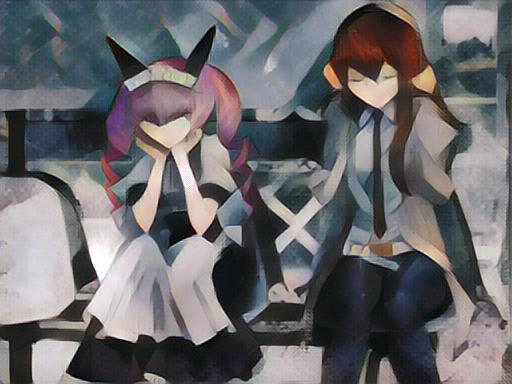
上面介绍了 Per-Image-Per-Model、Per-Style-Per-Model,Model 在保持质量的同时提高效率与通用性。下一步是如何更进一步,能将多种、甚至任意 Style 都通过一个 Model 来表达。我本已选择了较近期的一篇文章,"Universal style transfer via feature transforms.2017",作为例子讲解。然而,阅读后才发现文章最核心的"feature transforms"部分并非通过 Deep Learning 实现,而仅是通过简单地矩阵分解与变换实现,这种方式对于复杂图像很可能会丢失信息,限制通用性。通过简单几个实验,我也感觉到这种情况确实存在,具体结果如下。由于结果并不太符合预期,在此就不再详细介绍,相信后面很快会有改良的方案提出。

效果测试
从结果看,其实 Style Image 的风格确实有所保留。但是如上为所说,由于特征的变换比较简单粗暴,图像的细节畸变比较严重,只保留了 Content Image 中的主要轮廓。一眼看去,我的 Kurisu 仿佛是黑化了,为了不被揍,我就不贴其他触目惊心的结果了。

尾巴

最后还要强调的是,本文主要是希望简单回顾"风格迁移"的发展,顺便观察它们的效果,并非是严肃的结果复现或比较,带有较强的个人主观色彩。事实上经过测试,这些文章的结果大部分是超出我预期的,相信这个领域随后面还有更加强大、有趣的模型提出,让我们拭目以待!

REFERENCE

  1. Github: Neural-Style-Transfer-Papers
  2. 特殊矩陣 (14):Gramian 矩陣
  3. Transposed Convolution, Fractionally Strided Convolution or Deconvolution

via 当我们在谈论数据挖掘 - 知乎专栏 https://ift.tt/2OaBk5s
RSS Feed

RSS6

IFTTT

尴尬了,数据故事讲不好,模型再酷炫都没用

导言:数据科学风靡了几年,已经完成了从普及到应用的商业落地,越来越多的公司都已经同意数据驱动战略的重要性,但雇几个数据科学家和有一个数据团队,并不等同于公司就能坐享数据科学的果实。

数据科学家慢慢发现在科研阶段引以为豪的高端模型,在向没有技术背景的管理层做展示的时候毫无吸引力,得出的商业建议在付诸实施的时候也大打折扣。

作者认为要想做一个有影响力的数据科学家首先得学会讲好故事,他给出了三个有效建议来帮助数据科学家提高从洞察到行动的转换率。

有两类数据科学家:一类科学家专注于数据分析(A类),另一类专注于模型构建(B类)。

在数据科学项目中,两种科学家可能出现如下两种问题:

  • 模型不适用于应用体系。

  • 洞察的结果对于改进产品没有用处。

这两种结果常发生在从数据科学到其他领域的过渡之中:一种是从数据科学到软件工程,另一种是从数据科学到业务执行。

这两种转变是对现实生活创造价值和产生影响的关键,因此这个过程也存在很高的风险。

在模型交付过程中,软件工程师可能会说这些模型不符合他们的工程标准,商业部门的同事可能会说你的想法很有趣,但他们不会有所行动。这些这样那样的"借口"经常会丢给数据科学家们让他们很难取得成绩。这比数据科学领域其他挑战更令人担忧,因为我们无法左右数据分析成果在被转交后的命运。

尽管我们能做的非常有限,但我们应该采取一些行动来避免这两种结果。

模型部署在不同的机构中会有不同的效果,但是编写应用级代码可以帮助数据科学家进行更好的部署。

Trey Causey在他的博客中为数据科学家列出了编写应用级代码"所要做的一些事"

网址:

https://ift.tt/1IwVAHp

简而言之就是,使代码模块化,创建文档,使用版本控制(包含但不限于详细记录和建立测试)。

许多数据科学家习惯使用自上而下的命令式编码; 这种风格对与软件工程师合作制造了障碍。要使部署工作顺利进行,编写应用级代码很重要。

将想法转换为实际行动就像将"思维代码"部署到"社会机器"中一样。

如果数据科学家可以通过编写应用级代码来改进模型部署,那么数据科学家可以做些什么来改进商业战略落实呢?

用数据讲故事的能力是解决问题的关键。

数据背后引人入胜的故事可以给观众留下深刻印象并激励大家的行动力。用数据讲故事听起来很棒,但"讲故事"本身却是一个模糊的概念。为了真正深入了解数据故事,最近我回顾了Cole Knaflic撰写的《Storytelling with Data》和Nathan Yau编写的《Visualization that Means Something》。这两本书让我重新认识了用数据说话(讲故事)。

基于这两本书和我的经验,我想向你介绍优化结论向行动转换的策略。

概述:

  • 一开始就将想法观点亮出来

  • 在视觉层次上强调你的突破性结论

  • 提升结论到行动的转化率

把观点性结论放在展示最开始的部分

几个月前,我学会了一种呈现数据科学结果的方法。我认为这种方法很有效,我看到很多科学论文都采用了这种方法。

所以我的展示流程是,我从背景开始,讨论数据源,使用图形和表格来突出数据属性,讨论模型构建,讨论建模结果,最后总结观点(适当时要求采取行动)。

在这个流程中,想法见解是放在最后的,因为对数据和模型的基本解释会让观众真正理解观点做适当铺垫。

这个流程对我很有用,然而对于我的商业合作伙伴却不是这样——这些合作伙伴是商业实操的资深人士,但却是数据科学领域的门外汉(如今大多数决策者还是没有受过数据科学的专业培训)。

他们对我的数据探索过程不好奇,对建模细节也不感兴趣。他们只对这些见解感兴趣,因此建议我将数据细节移到附录中。

尽管我惊讶于他们对科学推理过程的不重视,但在我采纳他们的建议后,发现我的数据讲故事能够更快地与他们产生共鸣。

看来隐去数理推理过程的确更受欢迎。

为了做得更好,我回过头重新审视那些与我观点不直接相关的内容。现在,我讲的故事更多地围绕着结论而不是数据建模建立的过程。

乔什·伯诺夫(Josh Bernoff)在《Writing Without Bullshit》这本书中的一段很好地概括了上述的这种现象:

你必须颠倒你在学校学到的关于推理和写作的知识。在学校里,你学会先热身,再从第一原理开始慢慢推导出结论。但商业背景的读者没有热身时间,对推理过程缺乏耐心,除非他们提前知道目的是什么,回报是什么。所以从鲜明的观点陈述和结论开始,然后配上你的依据和理由。这样,读者不必阅读整篇文档就可以有所收获。

我仍然和我的技术同事用行话交流,然而,打交道的决策层次越高,我就越需要像Josh所说的那样先说结论再说依据。

另一个职业——咨询顾问,一直以来支撑着企业高管作出决策。

好像咨询顾问早就意识到需要先把观点摆在前面的重要性。

我找到了咨询顾问写的一篇关于家庭语音银行的研究论文。

本文采用的流程就是久经考验的讲故事方式。

来自咨询公司的研究论文中的目录

正如在上面的目录中可以看到的,顾问在"执行摘要"之后需立即提出"建议",而将研究方法放在最后一个章节。

其中在一开始就有大胆的结论和建议,也包含了决策可能产生的后果。

在本文中,市场对智能语音银行业务的需求很低,因此顾问建议银行对此持谨慎态度。对于顾问而言这是是常见的方法。无论是写作还是演讲,在最显眼的位置需要展示最重要的内容。

为了实现见解与行动的转化,应该把观点放在最开始的地方。

在视觉层次上强调突出你的结论倾向

数据可视化效果直接决定数据故事的好坏。数据可视化有表格和图形,包括视觉线索,坐标系统,比例尺,周围文本等形式。

数据可视化既是一种很好的信息交流方式,所谓"一图胜千言";同时也是一种很好的分析方式,正如John Tukey在《探索性数据分析(Exploratory Data Analysis)》中所说的"图片的最大价值在于它使我们注意到我们之前从未注意过的东西"。

鉴于数据可视化的有用性,我们可以通过更好地使用数据可视化来显著提高数据的"故事性"。

以前我的数据可视化优化策略是把图表做得更好看。我会浏览我起草的表格和图表,选择最有趣的表格,添加缺失的标题、图例和颜色,最后将它们放入我的演示文稿中。

这种方法一直效果不错,直到最近,当信息就呈现在我的同事面前,但他们还在问我信息在哪儿的时候。我这才意识到,我的图表虽然展示了信息但并没有传达出该关注图表哪个区域的信号。

在《Storytelling with Data and Visualization that Means Something》一书中,借助潜意识属性来创建有层次的视觉结构这一概念可以帮助我们体验到数据可视化真正的力量。

数据可视化不仅仅是使用正确的格式展示数据,更是用暗示性的视觉指示来引导观众更好地理解图片给出的信息,在视觉结构的最顶层给出观点。

我将使用两个案例进行说明。

以下是Cole Knaflic的案例研究。下面的第一张图是典型的线性图。线形图多用于在时间序列上的研究、重复测量研究等。

下面的图表有正确的标题、坐标轴和图例。从技术标准来看这是一个还不错的图表。但是,读者几乎不知道它想说什么。

数据是由投资者提供的,百分比之和大于100是因为调查者可以作出多个选择

改进之后的版本则是使用了潜意识属性。下面的图表中使用加粗的蓝色折线突出了最大的增长趋势,而其它所有的趋势则是采用了灰色,使其和背景融为一体。经由更好的视觉层次的结构,读者可以更加轻松的理解这张数据可视化图表。

在我采取这种方法之后,每当我采用前注意的特性来突出我想表达的内容的时候,我可以立刻注意到观众的反馈来得更快,更加强烈而且更加积极。这证明了在视觉层次的强调的确有效果。

在另外一个案例研究中,Cole Knaflic阐述了标题的强大之处。在下面的图表中,标题不是典型的"请求数量的时间趋势图",这样的标题是描述性的,但不够直接。而这里给出的标题是"请批准雇佣两名全职员工",给出了一个明确可采取的措施。这个建议帮助读者从趋势线中找到了因为两名员工的离职所导致的绩效差距。

我总是使用描述性的标题:"X随Y变化的趋势","A随B的分布"等等。现在我的标题是一个建议,问题或者真知灼见。标题是数据可视化中最重要的一个部分,一个充满张力的标题将极大提升信息输出效率。

我强烈推荐Cole和Nathan的图书《Storytelling with Data: A Data Visualization Guide for Business Professionals》 ,书中还有很多其它的技巧会对你产生帮助。

链接:

http://flowingdata.com 

http:/https://ift.tt/YHCvfr

提高洞察到行动的转化率

利用数据讲故事不是一个一次性的展示。你会被要求一遍又一遍的对不同利益相关者讲述同一个故事,特别是当你的真知灼见成功地与初始受众产生共鸣的时候。整个过程就像一个路演,你可以利用你的数据故事来活得尽可能多的支持。

有了足够多的支持之后,人们就会开始采取行动:利用不同的方式定位消费潜力,调整目前的战略从而提高运营效率,关闭不必要的产品功能,推出新流程来防范风险等等。

正如中国的一句谚语:牵一发而动全身。把你得出的建议转化为行动时,会对组织的各个部分产生连锁反应,而每个部门自然会从多个方向进行审查,而这些审查对于你的分析来说相当于一次压力测试。

本着一种怀疑的态度,人们可以对你的数据质量,假设和建模方法提出质疑。如果人们在你的原始数据中发现了错误,那么你故事的说服力会降低。

从不同的角度来看,人们可能会在你的关注点之外提出各种问题,这可能会导致额外的分析迭代过程。即使你基于数据的故事被别人完全接受,人们也可能会要求你提供数据,图表和数据模型从而进行进一步的分析。

人们还可能会要求你为了其它会议提供不同的图表。这些需求将促使你将分析的工作文档记录在案,使其可访问,模块化和可交互。如果你通过了这些压力测试并不断改进你的故事,你的故事会变得更加精巧,并且与实际行动更加接近。

路演有可能会成功,失败,或者介乎二者之间。A型数据科学家需要对预期和实际行动之间的转化情况有合理的预估。时至今日,每个商业领袖都高度重视由数据驱动的决策,而给出数据解决方案成为商业世界中最重要的环节。

但是这种趋势并不意味着决策仅仅将由数据驱动。决策本身仍然是科学与艺术的复杂调和,是数据逻辑和业务逻辑的混合体。在现实世界中,高管利用群策群力,定性和定量地来做出决策。

数据科学分析能够完全决定一项主要商业活动这句话并没有错误,但是也可能会起到误导作用。在过去,我认为如果一个数据分析的结果最终导致一个商业行动,那么这个数据分析本身是成功的。但是我现在看到了更多的商业案例,在这些案例中我们获得了一些真知灼见,但并没有转化为行动。

通过研究复杂的商业世界,我现在得出的结论是:将商业洞察转化为行动还取决于你的洞察有多大的影响力。而且A型数据科学家的成功不应该由它们的分析所带来的商业行动(和业务成果)来判断。放下对于数据科学可以化腐朽为神奇的幻想,并且承认洞察力的实际局限性有助于让我更好地专注打磨技巧,而不是被许多无法控制的事情分散注意力。

最后想说的话

商业洞察是数据科学工作的重要输出。我们寻找数据洞察力,因为我们需要洞察力来帮助我们让这个世界变得更美好。将洞察力转化为行动是将有价值的洞察力变为现实的方式。

由于数据科学家通常会将分析结果交给其他专业人士作决策,数据科学家应该更好地讲述数据背后的故事,从而能够更好地将洞察力转化为行动。通过把将商业建议放到演讲最开始的部分,并且在视觉上着重强调,数据科学家可以讲述更加打动人的数据故事,从而保持一个合理的从洞察到行动的转化率。

]]> 原文: https://ift.tt/2LRZxkr
RSS Feed

机器知心

IFTTT

AI开拓者Yann LeCun:深度网络优雅又闪耀

20世纪80年代中期,Mullet发型和粉红格子夹克大行其道(译者注:mullet发型是一种文化现象),精力充沛的Richard Simmons刚刚掀起健身狂潮,而人工智能(AI)方面的研究却几乎陷于停滞状态。

一方面,那时候计算机的计算能力还远达不到要求。早期的软盘驱动器在复杂程度上与现代的智能手机相比是小巫见大巫,计算机芯片在1989年以前也容纳不了数百万个组件,现今这个数字可以达到80亿。

另一方面,一片挥之不去的阴霾使得关于人工智能的一切幻想难以变为现实。1984年,美国人工智能学会举行了一次重大的会议,会议中该领域的先驱Marvin Minsky站出来警告商界:投资者对人工智能的热情最终带来的只会是失望。果不其然,人工智能投资开始逐步走向崩溃。

*Marvin Minsky

https://ift.tt/1tSy9Ei

现在看来,像Yann LeCun这样有远见的人没有持太多的悲观主义是一件幸事。这位土生土长的法国人,在加入新泽西州AT&T贝尔实验室的自适应系统研究部门时,甚至还不到30岁。

在那里,他对人工智能的热情日益高涨。

LeCun在贝尔实验室研究出了许多新的机器学习方法,其中包括卷积神经网络——由动物视觉皮质启发的模型。并且他的工作也促进了图像和视频识别,以及自然语言处理的进步。

"20世纪60年代后期,人工智能背景下的统计学习方法就像被判了死刑",LeCun回忆道。"人们或多或少地放弃了它。不过由于人们对神经网络的兴趣,它在80年代后期又重新回到了我们面前。当训练多层神经网络的学习算法在80年代中期出现时,统计学习方法曾掀起了一股热潮。"

在叙说这场革命的过程中,LeCun显得有点谦虚过头了。他的发现创造了历史,但他几乎没有提到过自己的名字或是成就。他拒绝把自己当回事;事实上他的个人网站上会有一整节全是双关语俏皮话,其中有这样的自我告诫:"反酷刑的日内瓦公约,以及反对残酷和施暴行为的美国宪法,禁止我凶残地连续使用三个以上双关语。"

LeCun也拒绝止步于自己在计算机科学方面业已获得的成就;如今,他担任Facebook的首席AI科学家,不知疲倦地努力实现新的突破。现在,我们跟着他来享受一次特权之旅——零距离接触这位学术明星——一起来探讨人工智能的成长历程,最新的变化以及它的潜力。

人工智能的开端——感知器触碰学习的边缘

LeCun熟知人工智能的发展历程,对其中的里程碑事件以及重要的人物如数家珍。故事从1956年夏天在达特茅斯举行的头脑风暴会议开始,"人工智能"一词即创造于此。

仅仅一年之后,Frank Rosenblatt在康奈尔航空实验室发明了感知器。其早期的实现之一是Mark 1感知器,这是一台庞大的矩形机器,包含400个光电池,它们被随机地连接到简单的图案检测器上,这些检测器将被用于可训练的分类器。

*Mark 1感知器:

https://ift.tt/2M12Jt7

"这是首个能够学会以一种非平凡的方式识别简单图案的神经网络",LeCun说。"你可以使用它们进行简单的图像识别,但它们不能识别出图像中的物体,也不能用于任何推理或设计。"

一直到过去十年,模式识别系统都需要大量的手工作业来识别自然图像中的物体。"你必须做很多工作以构建一个可以对图像做出表述的工程模块——这种表述通常是能被这些简单的学习算法处理的一长串数字。因此,基本上你不得不手工完成这项工作。" 他补充说,早期的语音识别机器翻译也是类似的情况:手工操作意味着要付出更多的努力,但收获甚微。

那么,迄今为止,计算机科学究竟发生了什么变化?"在所有这些应用中,深度学习神经网络已经带来了显著的性能提升——并且大大减少了之前必要的手工劳动",LeCun说。"这使得人们可以将这些应用扩展到许多不同的领域。"

那么问题来啦,计算机在一开始如何"学习"。

神经网络就像是大脑的软件模拟;它们处理诸如视觉图像之类的信息并试图得出正确的答案。但是,如果答案并不是很正确呢?这就要说到"反向传播"了,它是一种让神经网络能够学习的反馈流算法。

LeCun和反向传播

1986年,反向传播迎来了突破性的发现。当时,Geoffrey Hinton教授指出计算机可以通过反复执行任务来学习,每次都让神经网络"向误差减小的方向调整",他也成为最早描述该方法的研究者之一。

LeCun不仅实现了Hinton的早期理论,他还帮助奠定了基础。20世纪80年代早期,Hinton首先提出了"反向传播"的观点,但放弃了它,因为他认为它不起作用。

但在1985年,LeCun撰写了一篇论文,描述了一种反向传播的形式,正如他所说,"这是一个不起眼的会议。论文是用法语写的,基本上没有什么人阅读,但至少出现了一个重要的人。"而那个人就是Hinton。LeCun之后到了多伦多大学,在Hinton的指导下担任博士后研究助理,再后来他开始在AT&T贝尔实验室(晶体管的诞生地)工作。

"所有机器学习都是关于误差矫正的",LeCun解释道。想象一下,向计算机展示"成千上万的汽车和飞机图像,每次参数自我调整一点,输出就越接近正确的——如果你足够幸运的话,最终会确定一个结构,这时每辆汽车和每架飞机都能被正确识别。"

当他描述最终结果时,LeCun的回答让人敬畏:"学习的神奇之处在于,即使系统从未见过的图像也会被正确分类。"

尽管如此,他还是免不了变得有点淘气。"有各种各样的技巧可以让反向传播起作用,它仍然是一种神秘魔法——但现在我们有了一个秘诀。如果你遵循这个秘诀,它每次都会奏效。"

数据,AI和商业:未来和局限

人工智能时代的数据被喻为新黄金、新石油、新货币。是的,当今人人都知道:从审计到电子商务,数据对企业来说非常有价值。但是为了发挥出数据的作用,企业中的管理者就要区分数据能做什么和不能做什么。

LeCun认为:"对于用机器学习赋能业务,数据非常重要。你需要数据来训练你的系统。拥有的数据越多,系统就越准确。因此,不管从技术目标还是业务角度来看,数据都是多多益善的。"

但使用一段时间,你就会发现数据成了油腻的培根:也就是说,它无法让智能化的机器更加智能。

"无论是Facebook、Deep Mind、Google Brain还是其他机构的研究者,我们在研究人工智能时,都不使用内部数据来测试它们,"LeCun说道。"使用公共数据能够将我们的方法与学术界其他人的进行比较。拥有更多数据对于开发更好的方法并不重要。实际上,我们使用尽可能少的数据量,来使模型达到很好的表现。"

在学术研究中尤其如此,其中关键角色不是要处理大量的数据,而是成为LeCun所说的"新思想的先锋"。

"数据对于利用机器学习创造业务非常重要。你需要数据来训练你的系统。拥有的数据越多,系统就越准确。"

——Yann LeCun

同时,构建人工智能战略的企业需要在寻找解决方案之前进行自我评估。"这取决于AI对你的系统有多重要,"LeCun指出。"如果只想应用现有的AI方法,可以直接使用云服务。那么这样会相对容易。"一些企业和出租技术可以帮助人工智能的部署。

最大的挑战是那些希望建立自己的工程团队的公司。LeCun说:"总体来说,现在对人工智能工程师和科学家们的需求很高,而人才很稀缺,所以你必须付高价来雇佣他们。"

两种学习方式,一个光明的未来

LeCun概述了人工智能中两种不同类型的学习:监督学习和无监督学习监督学习适用于大部分机器学习的场景。利用监督学习,研究人员们训练模型来更好地识别图像或其他形式的输入。比如你可以把它想象成旋钮,通过自动调整,使机器的输出更接近你想要的。

虽然无监督学习或"自我监督"的学习在当今机器学习中占比很小,但却拥有很大的潜力。LeCun说:"这种学习方法是从本质上预测我们在世界上所感知到的一切。

现在的情况似乎是,需要预测将要发生什么才能获得下一步的突破。但可以肯定的是,对于科学家、学术界和高科技巨头来说,探索无监督学习的吸引力太大了。

这个研究的回报将能够完成我们目前不能做的所有应用。所以,希望能拥有智能虚拟助理,同他们交谈并理解你所说的一切。他们会切实地在日常生活中真正地帮助到你。

"这有点像电影《她》,你看过那部电影吗?"

简单介绍一下:这部电影在2013年由Spike Jonze执导,讲的是Joaquin Phoenix扮演的一个孤独作家,爱上了由Scarlett Johansson配音的虚拟助手。LeCun毫不掩盖对它的喜爱之情。

《她》电影海报

"这部影片描绘了人工智能成熟后,人们和他们的虚拟助手之间可能会发生交流,"他补充道说。"我们离发展出这样的AI技术还有很长的路要走。主要是因为现有的机器缺乏常识。"

"家猫都比最聪明的机器要更通人性"

——Yann LeCun

常识?但是在很多情况下机器不会比人类做出更好的决定吗?机器必须具有常识或者表现出来么? 

LeCun解释了为什么他们不这样做:"我们没有能力让机器学习庞大的背景知识:我们在生命的最初几周和几个月中得到了关于世界的大量背景知识,这和很多动物类似。"

因此,我们都知道机器人不能触水,就更别说洗碗水了。LeCun认为:我们制造不出灵巧的机器人,因为这些都超出了目前机器人技术的最新水平。不是我们无法制造机器人,而是我们不知道如何建立他们的大脑。我们不知道如何训练机器人理解我们的日常活动,例如绕过障碍以及如何放置物品。

鉴于LeCun在人工智能应用方面的地位,他的话听起似乎有些草率。但是,当他考虑到人工智能在医疗等领域的飞速发展时,他仍然对人工智能的未来抱有很大的希望与好奇。

他认为,通过医学图像分析,可以训练卷积神经网络来检测CT扫描图或MRIS中的肿瘤,或者从皮肤图像中检测黑色素瘤,这将对放射学产生深远的影响。

这正应了LeCun在7月8日,也就是58岁说过的一句话:"深度网络既优雅又闪耀。"

]]> 原文: https://ift.tt/2OcLnXv
RSS Feed

机器知心

IFTTT

软银千亿美元愿景基金第一年回报率:60%!孙正义又惊呆所有人

伊瓢 发自 凹非寺 量子位 报道 | 公众号 QbitAI

年投资回报60%。

在软银世界大会的晚宴上,孙正义透露了愿景基金成立第一年的投资回报。当然,这是他们内部估算的数值,还未经过合规部门审查。

愿景基金是软银旗下的投资基金,英文名vision fund,一经出生,它就被捧在了人工智能、高科技、大数据的宝座上,它的"父亲"孙正义从软银拿了一大笔钱来培养它,又从中东土豪那里借了数百亿美元,还让大名鼎鼎的科技公司苹果、高通等投了钱进来,凑了整整1000亿美元,用来投给科技公司。

61岁的老爷爷,亲力亲为搞投资

60%的高昂数字,1000亿美金,30多家公司,难以想象这些是61岁的孙正义老爷爷亲自推动完成的。虽然愿景基金已经建立了大约200人左右的投资团队,足以完成寻找投资标的、尽职调查这些工作,但孙正义仍然会在敲定TS之前亲自和每家背投公司的每个创始人沟通,甚至不只沟通一次。

孙正义的努力的确起到了效果,这不仅让他成为硅谷茶余饭后的热议人物,也让愿景基金获得了巨大的发展——他们内部已经开始考虑要不要出愿景基金2号了。

而此时,孙正义早已实现了好几个"财富自由",坐拥软银的近千亿美元市值。

孙正义经常在他位于加利福尼亚的豪宅中的会议室和被投公司创始人见面。2013年,孙正义以1.17亿美元的价格买下了这栋豪宅,据去过那里的企业创始人表示,这栋豪宅的会议室装修华丽,设有高档的木制品和十分巨大的电视屏幕。

这栋豪宅可以说是"深宅大院"了。如果有被投企业创始人,或是愿景基金的工作人员需要前去拜访孙正义的话,会有专门的保安人员将客人从公路边护送到门口,之后再由第二名保安人员带客人去孙正义的会客室。最后,像动漫里参观日本人的住宅一样,客人们换拖鞋进入房间,孙正义拿出他的日本弓来迎接客人,去会议室攀谈,讨论投资或是沟通经验。

鼓励"软银系"互相合作

对于自己投资的公司,孙正义希望他们之间能够相互合作,同时也在不断创造机会撮合这些合作。他对被投公司的高官们说:"你们现在是一个大家庭的一部分,意味着你们之间应当互相帮助。"

合作的内容包括互相交付订单等,孙正义认为这种合作可以帮助被投公司们迅速成长。

眼光长远,关注发展

许多被投公司创始人对孙正义的一大独特印象就是——眼光长远。

孙正义说过,自己要创建一家发展300年的公司,而这类长远考虑也体现在他对被投公司的计划上。他一直在催促创始人们,尽快扩张,扩大规模。

而软银的投资刚好利于完成这个任务:一旦听说某家公司接受了软银的投资,与该公司合作似乎就成了顺理成章的事情,因为他们一定有足够的资金和客户,来顺利实现自身发展。

1000亿美元怎么花?

这1000亿美元到底花得怎么样呢?我们来看看那些接受了愿景基金投资的科技公司。

芯片

在芯片领域,先是软银花320亿美元收购了高通、麒麟CPU们的爸爸ARM,又把其中25%的股份卖给了愿景基金;一年后,又用同样的"爸爸买来倒卖给儿子的手法",先是软银花40亿美元买下英伟达4.9%的股份,借着又以50亿美元的价格卖给了儿子愿景基金。

自动驾驶

在自动驾驶领域,愿景基金可以说下了功夫,去年七月,愿景基金参与了Nauto的1.59亿美元B轮融资;三个月后,又领投了地理定位平台Mapbox的1.64亿美金C轮融资;今年6月22.5亿美元投资了通用收购来的自动驾驶部门Cruise Automation,占股19.6%;

机器人

去年7月,愿景基金带着高通风投一起,投资了Brain Corp的1.14亿美元C轮融资,该公司通过BrainOS系统,让人们方便的训练机器人学习新技能。

除了这些,WeWork、Uber、滴滴等我们耳熟能详的公司也接受了愿景基金的投资。另外,上月底还有消息说独角兽商汤也即将接受愿景资本的10亿美元投资。

欢迎大家关注我们的专栏:量子位 - 知乎专栏

诚挚招聘

量子位正在招募编辑/记者,工作地点在北京中关村。期待有才气、有热情的同学加入我们!相关细节,请在量子位公众号(QbitAI)对话界面,回复"招聘"两个字。

量子位 QbitAI· 头条号签约作者

վ'ᴗ' ի 追踪AI技术和产品新动态


via 量子位 - 知乎专栏 https://ift.tt/2ADss6m
RSS Feed

RSS5

IFTTT

软银千亿美元愿景基金第一年回报率:60%!孙正义又惊呆所有人

伊瓢 发自 凹非寺 量子位 报道 | 公众号 QbitAI

年投资回报60%。

在软银世界大会的晚宴上,孙正义透露了愿景基金成立第一年的投资回报。当然,这是他们内部估算的数值,还未经过合规部门审查。

愿景基金是软银旗下的投资基金,英文名vision fund,一经出生,它就被捧在了人工智能、高科技、大数据的宝座上,它的"父亲"孙正义从软银拿了一大笔钱来培养它,又从中东土豪那里借了数百亿美元,还让大名鼎鼎的科技公司苹果、高通等投了钱进来,凑了整整1000亿美元,用来投给科技公司。

61岁的老爷爷,亲力亲为搞投资

60%的高昂数字,1000亿美金,30多家公司,难以想象这些是61岁的孙正义老爷爷亲自推动完成的。虽然愿景基金已经建立了大约200人左右的投资团队,足以完成寻找投资标的、尽职调查这些工作,但孙正义仍然会在敲定TS之前亲自和每家背投公司的每个创始人沟通,甚至不只沟通一次。

孙正义的努力的确起到了效果,这不仅让他成为硅谷茶余饭后的热议人物,也让愿景基金获得了巨大的发展——他们内部已经开始考虑要不要出愿景基金2号了。

而此时,孙正义早已实现了好几个"财富自由",坐拥软银的近千亿美元市值。

孙正义经常在他位于加利福尼亚的豪宅中的会议室和被投公司创始人见面。2013年,孙正义以1.17亿美元的价格买下了这栋豪宅,据去过那里的企业创始人表示,这栋豪宅的会议室装修华丽,设有高档的木制品和十分巨大的电视屏幕。

这栋豪宅可以说是"深宅大院"了。如果有被投企业创始人,或是愿景基金的工作人员需要前去拜访孙正义的话,会有专门的保安人员将客人从公路边护送到门口,之后再由第二名保安人员带客人去孙正义的会客室。最后,像动漫里参观日本人的住宅一样,客人们换拖鞋进入房间,孙正义拿出他的日本弓来迎接客人,去会议室攀谈,讨论投资或是沟通经验。

鼓励"软银系"互相合作

对于自己投资的公司,孙正义希望他们之间能够相互合作,同时也在不断创造机会撮合这些合作。他对被投公司的高官们说:"你们现在是一个大家庭的一部分,意味着你们之间应当互相帮助。"

合作的内容包括互相交付订单等,孙正义认为这种合作可以帮助被投公司们迅速成长。

眼光长远,关注发展

许多被投公司创始人对孙正义的一大独特印象就是——眼光长远。

孙正义说过,自己要创建一家发展300年的公司,而这类长远考虑也体现在他对被投公司的计划上。他一直在催促创始人们,尽快扩张,扩大规模。

而软银的投资刚好利于完成这个任务:一旦听说某家公司接受了软银的投资,与该公司合作似乎就成了顺理成章的事情,因为他们一定有足够的资金和客户,来顺利实现自身发展。

1000亿美元怎么花?

这1000亿美元到底花得怎么样呢?我们来看看那些接受了愿景基金投资的科技公司。

芯片

在芯片领域,先是软银花320亿美元收购了高通、麒麟CPU们的爸爸ARM,又把其中25%的股份卖给了愿景基金;一年后,又用同样的"爸爸买来倒卖给儿子的手法",先是软银花40亿美元买下英伟达4.9%的股份,借着又以50亿美元的价格卖给了儿子愿景基金。

自动驾驶

在自动驾驶领域,愿景基金可以说下了功夫,去年七月,愿景基金参与了Nauto的1.59亿美元B轮融资;三个月后,又领投了地理定位平台Mapbox的1.64亿美金C轮融资;今年6月22.5亿美元投资了通用收购来的自动驾驶部门Cruise Automation,占股19.6%;

机器人

去年7月,愿景基金带着高通风投一起,投资了Brain Corp的1.14亿美元C轮融资,该公司通过BrainOS系统,让人们方便的训练机器人学习新技能。

除了这些,WeWork、Uber、滴滴等我们耳熟能详的公司也接受了愿景基金的投资。另外,上月底还有消息说独角兽商汤也即将接受愿景资本的10亿美元投资。

欢迎大家关注我们的专栏:量子位 - 知乎专栏

诚挚招聘

量子位正在招募编辑/记者,工作地点在北京中关村。期待有才气、有热情的同学加入我们!相关细节,请在量子位公众号(QbitAI)对话界面,回复"招聘"两个字。

量子位 QbitAI· 头条号签约作者

վ'ᴗ' ի 追踪AI技术和产品新动态


via 量子位 - 知乎专栏 https://ift.tt/2ADss6m
RSS Feed

RSS5

IFTTT

DeepSeek + Pi 王炸组合跑赢 Claude Code?-InfoQ每周精要No.935

「每周精要」 ...