2018年8月3日星期五

2018谷歌学术影响因子发布:CVPR排名泛AI领域第一

安妮 雷刚 发自 凹非寺量子位 出品 | 公众号 QbitAI

学术出版哪家强?AI论文影响力是否又有新变化?

刚刚,谷歌发布了2018年最新版学术指标(Google Scholar Metrics,GSM)榜单。通过综合衡量学术会议和期刊论文中已发表的论文,谷歌对学术出版物及论文的影响力做出了排名。

在这份新出炉的榜单中,所有学术出版物中影响力Top 3是谁?对学术圈产生核弹式影响的那篇论文又出自谁手?人工智能领域期刊和顶会与历年相比有何变化,反映了什么问题?

别急,在接下来的内容中,量子位将一一介绍。要发车了,你准备好了么?

评价指标

和去年一样,2018年谷歌学术指标将出版物的范围划定至最近5年,即对2013年至2017的学术期刊论文及计算机科学和电气工程的相关会议论文进行评估。

和SCI影响因子的评估标准不同,谷歌主要依据3个评价因素

  • h指数(h-index):所有发表论文中,至少有h篇分别被引用了至少h次,则期刊/会议的h指数为h
  • h核心(h-core):指期刊/会议引用最多的h篇论文
  • h中值(h-median):h核心中引用次数的中位数

举个🌰,若某期刊共发表5篇论文,被引用次数分别为17、9、6、3和2次,则该杂志的h指数为3,h核心为被引用了17,9、6次的那几篇论文,h中值为9。

依据这样的标准,谷歌揭晓了所有领域学术出版物影响力最强的Top 100榜。不难发现,人工智能领域的期刊和会议,明显呈现上升势头

NIPS首次跻身Top 100

先看所有学术领域的Top 100榜局势如何——

影响力最高出版物Top 100榜单

和去年一样,Nature、The New England Journal of Medicine(《新英格兰医学杂志》)和Science还是雷打不动的前三名。

高居榜首的Nature中,目前被引次数最高的论文来自AI领域,题目极为简明:

Deep Learning。

这是一篇综述,由深度学习"三巨头"共同打造,发表于2015年5月,被引用次数已经达到8519次,比第二名高出3000多次。

要知道,谷歌去年放榜时,它在Nature论文中还只是排在第7,只被引用了2904次。

如果你还没有读过,这里有Hinton放出的PDF版:

https://ift.tt/2e5EQjC

地位飙升的不止这篇论文。人工智能相关学术会议的排名也在提升。

Top 100去年今年榜单对比可发现,CVPR的排名相比提升15名,位列No.20。而NIPS发力更猛,今年首次跻身Top 100榜,位居第54名,AI领域研究上升势头明显

无论CVPR还是NIPS,都是人工智能领域大家非常熟悉的顶级会议了。

CVPR(IEEE Conference on Computer Vision and Pattern Recognition)即IEEE国际计算机视觉与模式识别会议,一年举办一次。

而NIPS(Conference on Neural Information Processing Systems),全称神经信息处理系统大会,是每年12月举办的国际会议。不过,明年NIPS可能就要更名了。今年春天曾有一众大佬"死磕"NIPS,称这名字涉及色情和仇日,执行委员会目前正在讨论新名字~

其实,过去5年里,人工智能相关出版物的h指数也一直在提高,量子位直观地展示一下它们的上升速度:

CVPR一直遥遥领先,而NIPS上升势头非常迅猛,ICCV略逊一筹,之后是ICML和ECCV。计算机视觉期刊TPAMI五年来变化并不明显。

在这份Top 100榜下,谷歌还将英文出版物分为8类研究方向:

  • 商业、经济和管理
  • 化学和材料科学
  • 工程和计算机科学
  • 健康和医学科学
  • 人文、文学和艺术
  • 生命科学和地球科学
  • 物理和数学
  • 社会科学

上述每个方向均有若干更细小的具体研究领域。在工程和计算机科学分之下,还包含着人工智能、计算机视觉、机器人等58个领域的Top 20子榜单

泛AI领域排名总结

首先根据最新发布的榜单,量子位总结了一下在泛人工智能领域,讨论较多的知名学术会议或者期刊的2018年排名情况。

所谓泛人工智能领域,对应AI、CV、机器人、大数据等多个细分领域。以下是我们总结的情况:

CVPR

IEEE Conference on Computer Vision and Pattern Recognition, CVPR

h5-index:188

NIPS

Neural Information Processing Systems (NIPS)

h5-index:134

ICCV

IEEE International Conference on Computer Vision

h5-index:124

TPAMI

IEEE Transactions on Pattern Analysis and Machine Intelligence

h5-index:118

ICML

International Conference on Machine Learning (ICML)

h5-index:113

ECCV

European Conference on Computer Vision

h5-index:104

ESA

Expert Systems with Applications

h5 指数:92

ACL

Meeting of the Association for Computational Linguistics (ACL)

h5-index:87

KDD

ACM SIGKDD International Conference on Knowledge Discovery and Data Mining

h5-index:77

EMNLP

Conference on Empirical Methods in Natural Language Processing (EMNLP)

h5-index:76

ICRA

IEEE International Conference on Robotics and Automation

h5-index:75

AAAI

AAAI Conference on Artificial Intelligence

h5-index:69

IJCAI

International Joint Conference on Artificial Intelligence (IJCAI)

h5-index:61

各子榜单究竟如何?我们接着一个个看。

人工智能

在人工智能类目Top 20榜下,排名第1的是后起之秀NIPS,h5指数134,高于第2名ICML 21分。

人工智能影响力Top 20榜

在NIPS中,影响力Max的论文出自谷歌技术大牛Jeff Dean之手,论文题目为Distributed Representations of Words and Phrases and their Comp。

亚军ICML(International Conference on Machine Learning)的研究范围不难理解,其又称为国际机器学习大会,由国际机器学习学会主办,每年举办一次。

位列季军宝座的是英国期刊Expert Systems with Applications,主要研究方向包括信息科学、电子学、信息处理方法与技术。在谷歌学术指标中,其h5指数为92。

排名第4和第5的期刊均来自IEEE,这个建立于1963年的学会目前拥有来自175个国家的36万会员,且每个会员在研究中都"身怀绝技"。

其中,期刊IEEE Transactions On Systems, Man And Cybernetics Part B, Cybernetics主要研究人类、机器和组织在架构或神经层面的交流和控制,现已更名为IEEE Transactions on Cybernetics。

位列老5的兄弟期刊IEEE Transactions on Neural Networks and Learning Systems主要涉及神经网络和相关学习系统的理论,设计和应用的技术文章。

在Top 20的榜单中,我们熟悉的AAAI(美国人工智能协会)协会举办的年度大会位列11,但h5指数只有69,和前几名拉开了明显差距。

人工智能Top 20地址:

https://ift.tt/2vgY9xc

计算机视觉和模式识别

和人工智能分榜百家齐放、百花争鸣不同的是,视觉与模式识别类目中Top 5均和IEEE有关有关

在计算机视觉与模式识别类目Top 20榜下,CVPR位居首位,h5指数188,与第二名ICCV拉开了64分的差距。

视觉与模式识别影响力Top 20榜

顶会CVPR是IEEE Conference on Computer Vision and Pattern Recognition的缩写,即IEEE国际计算机视觉与模式识别会议。

而国际计算机视觉大会ICCV,也由IEEE主办,与排名第4的CVPR和欧洲计算机视觉会议(ECCV)并称计算机视觉方向的三大顶级会议。ICCV论文录用率非常低,是三大会议中公认级别最高的。

此外,前5名的机构还包括计算机视觉及模式识别领域最顶尖的SCI期刊TPAMI,和图像处理及计算机视觉领域公认的国际顶级期刊TIP(IEEE Transactions on Image Processing),它侧重图像处理的前沿理论与方法,需要非常强的创新性。

其中,CVPR中引用次数最高的论文出自华人团队

2016年发表的论文Deep Residual Learning for Image Recognition影响力最高,引用次数10480次,其作者为当时微软亚洲研究院的何恺明,张祥雨,任少卿和孙剑。

如今,何恺明已前往Facebook AI研究院,张祥雨和孙剑就职旷视科技研究院,任少卿则成为自动驾驶公司Momenta联合创始人和研发总监。

引用数第二的论文为Going Deeper With Convolutions,发表于2015年,主要介绍了谷歌的GoogLeNet。去年的统计中,该论文还是引用次数最多的CV领域论文,不过现已被ResNet超越~

视觉与模式识别Top 20地址:

https://ift.tt/2AI1Hhe

计算语言学

△ 计算语言学影响力Top 20榜

在语言学领域,已经形成一家独大的趋势,影响力前五的期刊/会议均属ACL家族

其中,ACL(The Association for Computational Linguistics,国际计算语言学会)影响力最高,h5指数87。成立于1962年的ACL于今年正式成立ACL亚太分会(AACL),首届预计于2020年举行,此后将每两年举行一次。

EMNLP全称自然语言处理实证方法会议(Conferenceon Empirical Methods in Natural Language Processing),由ACL学会下属特殊兴趣小组SIGDAT组织,每年召开一次。

NAACL HLT名义上是ACL北美分会,但在NLP圈里也是无可争议的顶级会议,名称中的 HLT也直接表示了对于人类语言处理技术的关注。

SemEval全称国际语义评测比赛(International Workshop on Semantic Evaluation),为ACL下属的SIGLEX主办。TACL(Transactions of the Association for Computational Linguistics,)是ACL旗下期刊。

其中,引用次数最多的ACL论文是The Stanford CoreNLP Natural Language Processing Toolkit,它发表于2014年,引用数达2537,为CD Manning, M Surdeanu, J Bauer, JR Finkel, S Bethard, D McClosky等人所作。

计算语言学Top 20榜传送门:

https://ift.tt/2OHgprC

机器人

△机器人类目影响力Top 20榜

在机器人类目中,ICRA以h5指数75位居榜首。ICRA全称IEEE International Conference on Robotics and Automation,是IEEE机器人与自动化学会主持的旗舰会议。

TM(IEEE/ASME Transactions on Mechatronics)位居第二,是机器人与机电系统领域顶级期刊,h5指数62。

IJRR(The International Journal of Robotics Research,国际机器人研究杂志),h5指数61位居分榜季军。此外,前五名还包括智能机器人与系统国际会议ICIRS,和机器人领域国际顶级期刊TR(IEEE Transactions on Robotics)。

这样看来,和语言学ACL家族一家独大类似,机器人类目下顶会和期刊大多隶属于IEEE家族

其中,引用次数最多的论文为SVO: Fast semi-direct monocular visual odometry,发表于2014年,作者为C Forster, M Pizzoli和D Scaramuzza三人。

想围观机器人子榜单可前往:

https://ift.tt/2ACKLc3

传送门

完整分类版榜单,可以科学移步谷歌2018年学术指数榜单首页:

https://ift.tt/2vgpMGK

官方博客上面还有介绍:

https://ift.tt/2ACKLJ5

祝天下所有研究人员学有所得。

欢迎大家关注我们的专栏:量子位 - 知乎专栏

诚挚招聘

量子位正在招募编辑/记者,工作地点在北京中关村。期待有才气、有热情的同学加入我们!相关细节,请在量子位公众号(QbitAI)对话界面,回复"招聘"两个字。

量子位 QbitAI· 头条号签约作者

վ'ᴗ' ի 追踪AI技术和产品新动态


via 量子位 - 知乎专栏 https://ift.tt/2vgYboO
RSS Feed

RSS5

IFTTT

2018谷歌学术影响因子发布:CVPR排名泛AI领域第一

安妮 雷刚 发自 凹非寺量子位 出品 | 公众号 QbitAI

学术出版哪家强?AI论文影响力是否又有新变化?

刚刚,谷歌发布了2018年最新版学术指标(Google Scholar Metrics,GSM)榜单。通过综合衡量学术会议和期刊论文中已发表的论文,谷歌对学术出版物及论文的影响力做出了排名。

在这份新出炉的榜单中,所有学术出版物中影响力Top 3是谁?对学术圈产生核弹式影响的那篇论文又出自谁手?人工智能领域期刊和顶会与历年相比有何变化,反映了什么问题?

别急,在接下来的内容中,量子位将一一介绍。要发车了,你准备好了么?

评价指标

和去年一样,2018年谷歌学术指标将出版物的范围划定至最近5年,即对2013年至2017的学术期刊论文及计算机科学和电气工程的相关会议论文进行评估。

和SCI影响因子的评估标准不同,谷歌主要依据3个评价因素

  • h指数(h-index):所有发表论文中,至少有h篇分别被引用了至少h次,则期刊/会议的h指数为h
  • h核心(h-core):指期刊/会议引用最多的h篇论文
  • h中值(h-median):h核心中引用次数的中位数

举个🌰,若某期刊共发表5篇论文,被引用次数分别为17、9、6、3和2次,则该杂志的h指数为3,h核心为被引用了17,9、6次的那几篇论文,h中值为9。

依据这样的标准,谷歌揭晓了所有领域学术出版物影响力最强的Top 100榜。不难发现,人工智能领域的期刊和会议,明显呈现上升势头

NIPS首次跻身Top 100

先看所有学术领域的Top 100榜局势如何——

影响力最高出版物Top 100榜单

和去年一样,Nature、The New England Journal of Medicine(《新英格兰医学杂志》)和Science还是雷打不动的前三名。

高居榜首的Nature中,目前被引次数最高的论文来自AI领域,题目极为简明:

Deep Learning。

这是一篇综述,由深度学习"三巨头"共同打造,发表于2015年5月,被引用次数已经达到8519次,比第二名高出3000多次。

要知道,谷歌去年放榜时,它在Nature论文中还只是排在第7,只被引用了2904次。

如果你还没有读过,这里有Hinton放出的PDF版:

https://ift.tt/2e5EQjC

地位飙升的不止这篇论文。人工智能相关学术会议的排名也在提升。

Top 100去年今年榜单对比可发现,CVPR的排名相比提升15名,位列No.20。而NIPS发力更猛,今年首次跻身Top 100榜,位居第54名,AI领域研究上升势头明显

无论CVPR还是NIPS,都是人工智能领域大家非常熟悉的顶级会议了。

CVPR(IEEE Conference on Computer Vision and Pattern Recognition)即IEEE国际计算机视觉与模式识别会议,一年举办一次。

而NIPS(Conference on Neural Information Processing Systems),全称神经信息处理系统大会,是每年12月举办的国际会议。不过,明年NIPS可能就要更名了。今年春天曾有一众大佬"死磕"NIPS,称这名字涉及色情和仇日,执行委员会目前正在讨论新名字~

其实,过去5年里,人工智能相关出版物的h指数也一直在提高,量子位直观地展示一下它们的上升速度:

CVPR一直遥遥领先,而NIPS上升势头非常迅猛,ICCV略逊一筹,之后是ICML和ECCV。计算机视觉期刊TPAMI五年来变化并不明显。

在这份Top 100榜下,谷歌还将英文出版物分为8类研究方向:

  • 商业、经济和管理
  • 化学和材料科学
  • 工程和计算机科学
  • 健康和医学科学
  • 人文、文学和艺术
  • 生命科学和地球科学
  • 物理和数学
  • 社会科学

上述每个方向均有若干更细小的具体研究领域。在工程和计算机科学分之下,还包含着人工智能、计算机视觉、机器人等58个领域的Top 20子榜单

泛AI领域排名总结

首先根据最新发布的榜单,量子位总结了一下在泛人工智能领域,讨论较多的知名学术会议或者期刊的2018年排名情况。

所谓泛人工智能领域,对应AI、CV、机器人、大数据等多个细分领域。以下是我们总结的情况:

CVPR

IEEE Conference on Computer Vision and Pattern Recognition, CVPR

h5-index:188

NIPS

Neural Information Processing Systems (NIPS)

h5-index:134

ICCV

IEEE International Conference on Computer Vision

h5-index:124

TPAMI

IEEE Transactions on Pattern Analysis and Machine Intelligence

h5-index:118

ICML

International Conference on Machine Learning (ICML)

h5-index:113

ECCV

European Conference on Computer Vision

h5-index:104

ESA

Expert Systems with Applications

h5 指数:92

ACL

Meeting of the Association for Computational Linguistics (ACL)

h5-index:87

KDD

ACM SIGKDD International Conference on Knowledge Discovery and Data Mining

h5-index:77

EMNLP

Conference on Empirical Methods in Natural Language Processing (EMNLP)

h5-index:76

ICRA

IEEE International Conference on Robotics and Automation

h5-index:75

AAAI

AAAI Conference on Artificial Intelligence

h5-index:69

IJCAI

International Joint Conference on Artificial Intelligence (IJCAI)

h5-index:61

各子榜单究竟如何?我们接着一个个看。

人工智能

在人工智能类目Top 20榜下,排名第1的是后起之秀NIPS,h5指数134,高于第2名ICML 21分。

人工智能影响力Top 20榜

在NIPS中,影响力Max的论文出自谷歌技术大牛Jeff Dean之手,论文题目为Distributed Representations of Words and Phrases and their Comp。

亚军ICML(International Conference on Machine Learning)的研究范围不难理解,其又称为国际机器学习大会,由国际机器学习学会主办,每年举办一次。

位列季军宝座的是英国期刊Expert Systems with Applications,主要研究方向包括信息科学、电子学、信息处理方法与技术。在谷歌学术指标中,其h5指数为92。

排名第4和第5的期刊均来自IEEE,这个建立于1963年的学会目前拥有来自175个国家的36万会员,且每个会员在研究中都"身怀绝技"。

其中,期刊IEEE Transactions On Systems, Man And Cybernetics Part B, Cybernetics主要研究人类、机器和组织在架构或神经层面的交流和控制,现已更名为IEEE Transactions on Cybernetics。

位列老5的兄弟期刊IEEE Transactions on Neural Networks and Learning Systems主要涉及神经网络和相关学习系统的理论,设计和应用的技术文章。

在Top 20的榜单中,我们熟悉的AAAI(美国人工智能协会)协会举办的年度大会位列11,但h5指数只有69,和前几名拉开了明显差距。

人工智能Top 20地址:

https://ift.tt/2vgY9xc

计算机视觉和模式识别

和人工智能分榜百家齐放、百花争鸣不同的是,视觉与模式识别类目中Top 5均和IEEE有关有关

在计算机视觉与模式识别类目Top 20榜下,CVPR位居首位,h5指数188,与第二名ICCV拉开了64分的差距。

视觉与模式识别影响力Top 20榜

顶会CVPR是IEEE Conference on Computer Vision and Pattern Recognition的缩写,即IEEE国际计算机视觉与模式识别会议。

而国际计算机视觉大会ICCV,也由IEEE主办,与排名第4的CVPR和欧洲计算机视觉会议(ECCV)并称计算机视觉方向的三大顶级会议。ICCV论文录用率非常低,是三大会议中公认级别最高的。

此外,前5名的机构还包括计算机视觉及模式识别领域最顶尖的SCI期刊TPAMI,和图像处理及计算机视觉领域公认的国际顶级期刊TIP(IEEE Transactions on Image Processing),它侧重图像处理的前沿理论与方法,需要非常强的创新性。

其中,CVPR中引用次数最高的论文出自华人团队

2016年发表的论文Deep Residual Learning for Image Recognition影响力最高,引用次数10480次,其作者为当时微软亚洲研究院的何恺明,张祥雨,任少卿和孙剑。

如今,何恺明已前往Facebook AI研究院,张祥雨和孙剑就职旷视科技研究院,任少卿则成为自动驾驶公司Momenta联合创始人和研发总监。

引用数第二的论文为Going Deeper With Convolutions,发表于2015年,主要介绍了谷歌的GoogLeNet。去年的统计中,该论文还是引用次数最多的CV领域论文,不过现已被ResNet超越~

视觉与模式识别Top 20地址:

https://ift.tt/2AI1Hhe

计算语言学

△ 计算语言学影响力Top 20榜

在语言学领域,已经形成一家独大的趋势,影响力前五的期刊/会议均属ACL家族

其中,ACL(The Association for Computational Linguistics,国际计算语言学会)影响力最高,h5指数87。成立于1962年的ACL于今年正式成立ACL亚太分会(AACL),首届预计于2020年举行,此后将每两年举行一次。

EMNLP全称自然语言处理实证方法会议(Conferenceon Empirical Methods in Natural Language Processing),由ACL学会下属特殊兴趣小组SIGDAT组织,每年召开一次。

NAACL HLT名义上是ACL北美分会,但在NLP圈里也是无可争议的顶级会议,名称中的 HLT也直接表示了对于人类语言处理技术的关注。

SemEval全称国际语义评测比赛(International Workshop on Semantic Evaluation),为ACL下属的SIGLEX主办。TACL(Transactions of the Association for Computational Linguistics,)是ACL旗下期刊。

其中,引用次数最多的ACL论文是The Stanford CoreNLP Natural Language Processing Toolkit,它发表于2014年,引用数达2537,为CD Manning, M Surdeanu, J Bauer, JR Finkel, S Bethard, D McClosky等人所作。

计算语言学Top 20榜传送门:

https://ift.tt/2OHgprC

机器人

△机器人类目影响力Top 20榜

在机器人类目中,ICRA以h5指数75位居榜首。ICRA全称IEEE International Conference on Robotics and Automation,是IEEE机器人与自动化学会主持的旗舰会议。

TM(IEEE/ASME Transactions on Mechatronics)位居第二,是机器人与机电系统领域顶级期刊,h5指数62。

IJRR(The International Journal of Robotics Research,国际机器人研究杂志),h5指数61位居分榜季军。此外,前五名还包括智能机器人与系统国际会议ICIRS,和机器人领域国际顶级期刊TR(IEEE Transactions on Robotics)。

这样看来,和语言学ACL家族一家独大类似,机器人类目下顶会和期刊大多隶属于IEEE家族

其中,引用次数最多的论文为SVO: Fast semi-direct monocular visual odometry,发表于2014年,作者为C Forster, M Pizzoli和D Scaramuzza三人。

想围观机器人子榜单可前往:

https://ift.tt/2ACKLc3

传送门

完整分类版榜单,可以科学移步谷歌2018年学术指数榜单首页:

https://ift.tt/2vgpMGK

官方博客上面还有介绍:

https://ift.tt/2ACKLJ5

祝天下所有研究人员学有所得。

欢迎大家关注我们的专栏:量子位 - 知乎专栏

诚挚招聘

量子位正在招募编辑/记者,工作地点在北京中关村。期待有才气、有热情的同学加入我们!相关细节,请在量子位公众号(QbitAI)对话界面,回复"招聘"两个字。

量子位 QbitAI· 头条号签约作者

վ'ᴗ' ի 追踪AI技术和产品新动态


via 量子位 - 知乎专栏 https://ift.tt/2vgYboO
RSS Feed

RSS5

IFTTT

AlphaGo Zero你也造一只,此处有PyTorch实现

原作 Dylan Djian栗子棋 编译整理量子位 出品 | 公众号 QbitAI
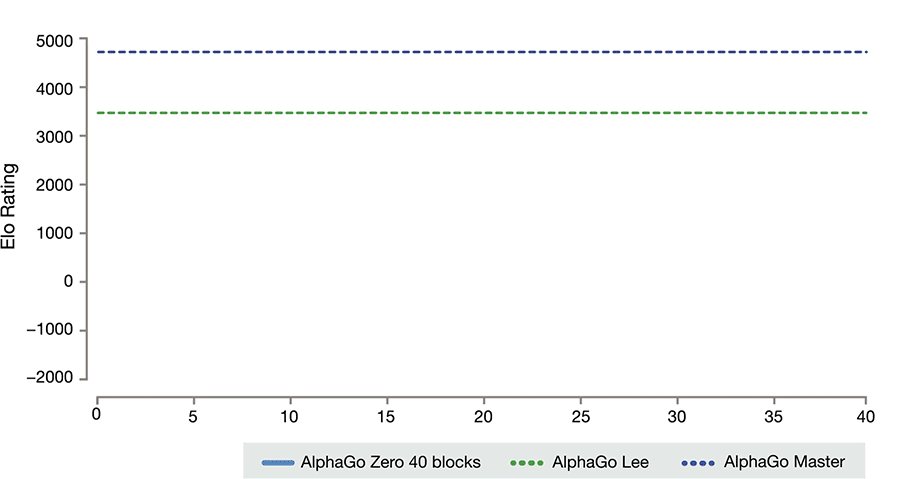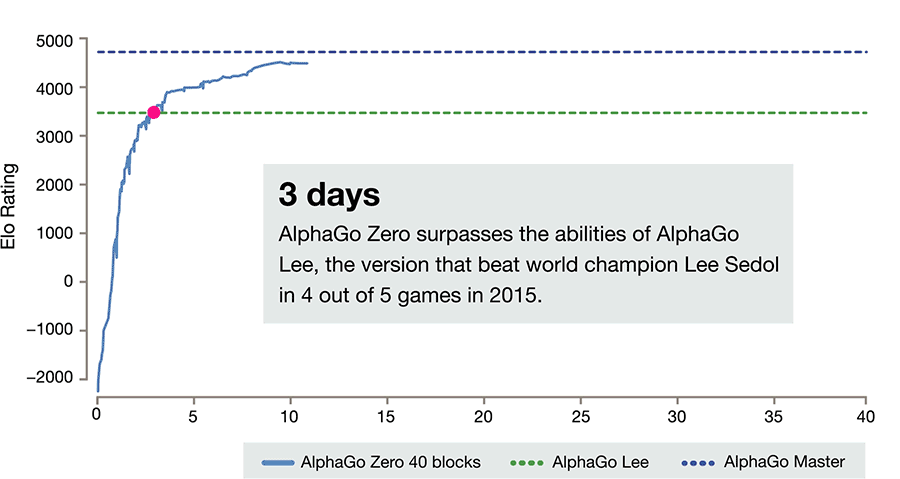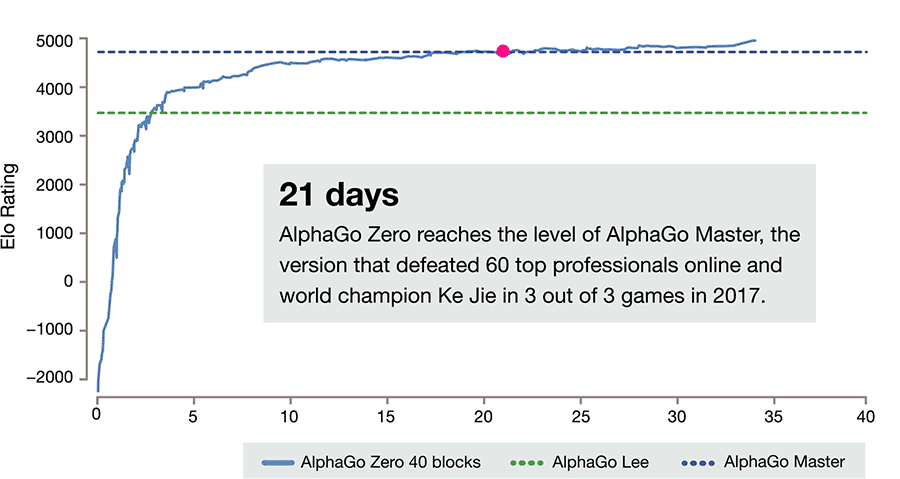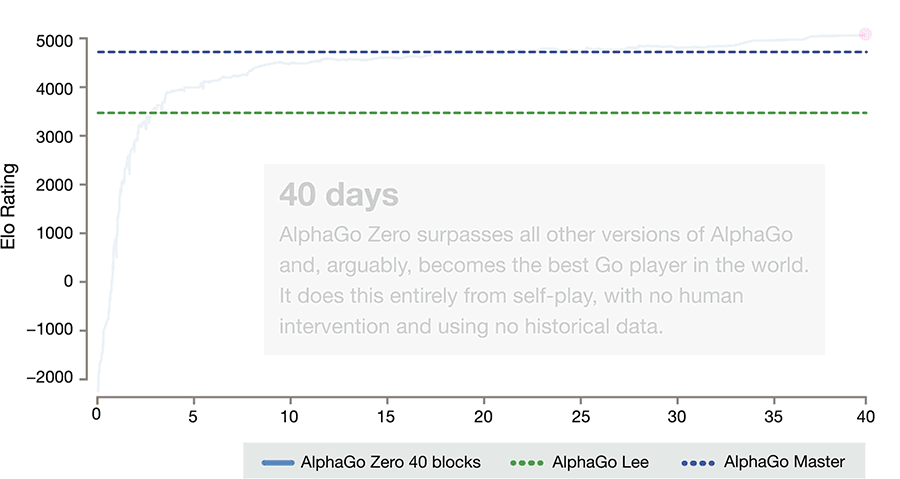
遥想当年,AlphaGo的Master版本,在完胜柯洁九段之后不久,就被后辈AlphaGo Zero (简称狗零) 击溃了。

从一只完全不懂围棋的AI,到打败Master,狗零只用了21天

而且,它不需要用人类知识来喂养,成为顶尖棋手全靠自学

如果能培育这样一只AI,即便自己不会下棋,也可以很骄傲吧。

于是,来自巴黎的少年Dylan Djian (简称小笛) ,就照着自己对狗零论文的理解,用PyTorch实现了一下。
他给自己的AI棋手起名SuperGo,也提供了代码 (传送门见文底) 。

除此之外,还有教程——

一个身子两个头

智能体分成三个部分:

一是特征提取器 (Feature Extractor) ,二是策略网络 (Policy Network) ,三是价值网络 (Value Network) 。

于是,狗零也被亲切地称为"双头怪"。特征提取器是身子,其他两个网络是脑子

特征提取器

特征提取模型,是个残差网络 (ResNet) ,就是给普通CNN加上了跳层连接 (Skip Connection) , 让梯度的传播更加通畅。
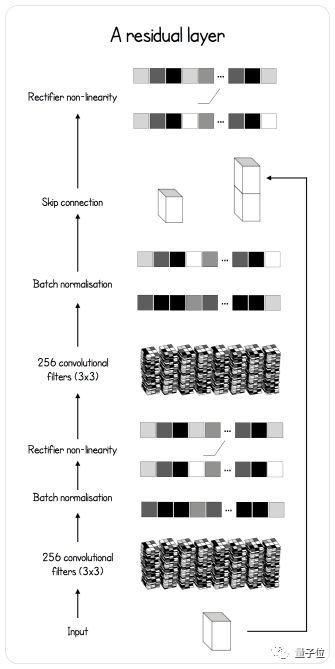
跳跃的样子,写成代码就是:

 1 class BasicBlock(nn.Module):  2     """  3     Basic residual block with 2 convolutions and a skip connection  4     before the last ReLU activation.  5     """   6  7     def __init__(self, inplanes, planes, stride=1, downsample=None):  8         super(BasicBlock, self).__init__()  9 10         self.conv1 = nn.Conv2d(inplanes, planes, kernel_size=3, 11                         stride=stride, padding=1, bias=False) 12         self.bn1 = nn.BatchNorm2d(planes) 13 14         self.conv2 = nn.Conv2d(planes, planes, kernel_size=3, 15                         stride=stride, padding=1, bias=False) 16         self.bn2 = nn.BatchNorm2d(planes) 17 18 19     def forward(self, x): 20         residual = x 21 22         out = self.conv1(x) 23         out = F.relu(self.bn1(out)) 24 25         out = self.conv2(out) 26         out = self.bn2(out) 27 28         out += residual 29         out = F.relu(out) 30 31         return out

然后,把它加到特征提取模型里面去:

 1 class Extractor(nn.Module):  2     def __init__(self, inplanes, outplanes):  3         super(Extractor, self).__init__()  4         self.conv1 = nn.Conv2d(inplanes, outplanes, stride=1,  5                         kernel_size=3, padding=1, bias=False)  6         self.bn1 = nn.BatchNorm2d(outplanes)  7   8         for block in range(BLOCKS):  9             setattr(self, "res{}".format(block), \ 10                 BasicBlock(outplanes, outplanes)) 11 12 13     def forward(self, x): 14         x = F.relu(self.bn1(self.conv1(x))) 15         for block in range(BLOCKS - 1): 16             x = getattr(self, "res{}".format(block))(x) 17 18         feature_maps = getattr(self, "res{}".format(BLOCKS - 1))(x) 19         return feature_maps

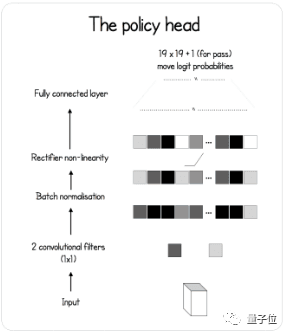
策略网络

策略网络就是普通的CNN了,里面有个批量标准化 (Batch Normalization) ,还有一个全连接层,输出概率分布

 1 class PolicyNet(nn.Module):  2     def __init__(self, inplanes, outplanes):  3         super(PolicyNet, self).__init__()  4         self.outplanes = outplanes  5         self.conv = nn.Conv2d(inplanes, 1, kernel_size=1)  6         self.bn = nn.BatchNorm2d(1)  7         self.logsoftmax = nn.LogSoftmax(dim=1)  8         self.fc = nn.Linear(outplanes - 1, outplanes)  9 10 11     def forward(self, x): 12         x = F.relu(self.bn(self.conv(x))) 13         x = x.view(-1, self.outplanes - 1) 14         x = self.fc(x) 15         probas = self.logsoftmax(x).exp() 16 17         return probas

价值网络

这个网络稍微复杂一点。除了标配之外,还要再多加一个全连接层。最后,用双曲正切 (Hyperbolic Tangent) 算出 (-1,1) 之间的数值,来表示当前状态下的赢面多大。
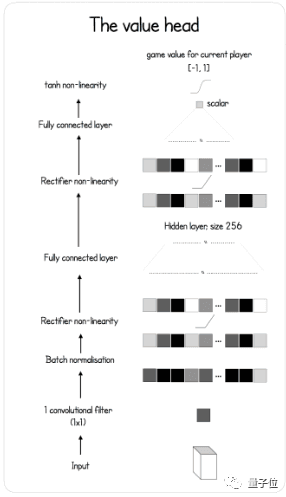
代码长这样——

 1 class ValueNet(nn.Module):  2     def __init__(self, inplanes, outplanes):  3         super(ValueNet, self).__init__()  4         self.outplanes = outplanes  5         self.conv = nn.Conv2d(inplanes, 1, kernel_size=1)  6         self.bn = nn.BatchNorm2d(1)  7         self.fc1 = nn.Linear(outplanes - 1, 256)  8         self.fc2 = nn.Linear(256, 1)  9  10  11     def forward(self, x): 12         x = F.relu(self.bn(self.conv(x))) 13         x = x.view(-1, self.outplanes - 1) 14         x = F.relu(self.fc1(x)) 15         winning = F.tanh(self.fc2(x)) 16         return winning

未雨绸缪的树

狗零,还有一个很重要的组成部分,就是蒙特卡洛树搜索 (MCTS) 。

它可以让AI棋手提前找出,胜率最高的落子点。

在模拟器里,模拟对方的下一手,以及再下一手,给出应对之策,所以提前的远不止是一步

节点 (Node)

树上的每一个节点,都代表一种不同的局势,有不同的统计数据:

每个节点被经过的次数n,总动作值w,经过这一点的先验概率p,平均动作值q (q=w/n) ,还有从别处来到这个节点走的那一步,以及从这个节点出发、所有可能的下一步

1 class Node: 2     def __init__(self, parent=None, proba=None, move=None): 3         self.p = proba 4         self.n = 0 5         self.w = 0 6         self.q = 0 7         self.children = [] 8         self.parent = parent 9         self.move = move

部署 (Rollout)

第一步是PUCT (多项式上置信树) 算法,选择能让PUCT函数 (下图) 的某个变体 (Variant) 最大化,的走法。
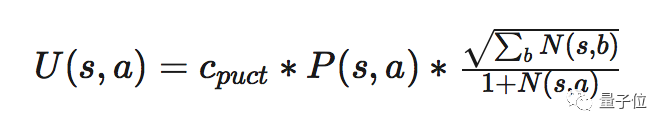
写成代码的话——

 1 def select(nodes, c_puct=C_PUCT):  2     " Optimized version of the selection based of the PUCT formula "  3   4     total_count = 0  5     for i in range(nodes.shape[0]):  6         total_count += nodes[i][1]  7  8     action_scores = np.zeros(nodes.shape[0])  9     for i in range(nodes.shape[0]): 10         action_scores[i] = nodes[i][0] + c_puct * nodes[i][2] * \ 11                 (np.sqrt(total_count) / (1 + nodes[i][1])) 12  13     equals = np.where(action_scores == np.max(action_scores))[0] 14     if equals.shape[0] > 0: 15         return np.random.choice(equals) 16     return equals[0]

结束 (Ending)

选择在不停地进行,直至到达一个叶节点 (Leaf Node) ,而这个节点还没有往下生枝。

1 def is_leaf(self): 2     """ Check whether a node is a leaf or not """ 3  4     return len(self.children) == 0

到了叶节点,那里的一个随机状态就会被评估,得出所有"下一步"的概率。

所有被禁的落子点,概率会变成零,然后重新把总概率归为1。

然后,这个叶节点就会生出枝节 (都是可以落子的位置,概率不为零的那些) 。代码如下——

1 def expand(self, probas): 2     self.children = [Node(parent=self, move=idx, proba=probas[idx]) \ 3                 for idx in range(probas.shape[0]) if probas[idx] > 0]

更新一下

枝节生好之后,这个叶节点和它的妈妈们,身上的统计数据都会更新,用的是下面这两串代码。

1 def update(self, v): 2     """ Update the node statistics after a rollout """ 3  4     self.w = self.w + v 5     self.q = self.w / self.n if self.n > 0 else 0 1 while current_node.parent: 2     current_node.update(v) 3     current_node = current_node.parent

选择落子点

模拟器搭好了,每个可能的"下一步",都有了自己的统计数据。

按照这些数据,算法会选择其中一步,真要落子的地方。

选择有两种,一就是选择被模拟的次数最多的点。试用于测试和实战。

另外一种,随机 (Stochastically) 选择,把节点被经过的次数转换成概率分布,用的是以下代码——

1 total = np.sum(action_scores) 2 probas = action_scores / total 3 move = np.random.choice(action_scores.shape[0], p=probas)

后者适用于训练,让AlphaGo探索更多可能的选择。

三位一体的修炼

狗零的修炼分为三个过程,是异步的。

一是自对弈 (Self-Play) ,用来生成数据。

 1 def self_play():  2     while True:  3         new_player, checkpoint = load_player()  4         if new_player:  5             player = new_player  6   7         ## Create the self-play match queue of processes  8         results = create_matches(player, cores=PARALLEL_SELF_PLAY,  9                                          match_number=SELF_PLAY_MATCH)  10         for _ in range(SELF_PLAY_MATCH): 11             result = results.get() 12             db.insert({ 13                 "game": result, 14                 "id": game_id 15             }) 16             game_id += 1

二是训练 (Training) ,拿新鲜生成的数据,来改进当前的神经网络。

 1 def train():  2     criterion = AlphaLoss()  3     dataset = SelfPlayDataset()  4     player, checkpoint = load_player(current_time, loaded_version)   5     optimizer = create_optimizer(player, lr,  6                                     param=checkpoint['optimizer'])  7     best_player = deepcopy(player)  8     dataloader = DataLoader(dataset, collate_fn=collate_fn, \  9                 batch_size=BATCH_SIZE, shuffle=True) 10  11     while True: 12         for batch_idx, (state, move, winner) in enumerate(dataloader): 13  14             ## Evaluate a copy of the current network 15             if total_ite % TRAIN_STEPS == 0: 16                 pending_player = deepcopy(player) 17                 result = evaluate(pending_player, best_player) 18  19                 if result: 20                     best_player = pending_player 21  22             example = { 23                 'state': state, 24                 'winner': winner, 25                 'move' : move 26             } 27             optimizer.zero_grad() 28             winner, probas = pending_player.predict(example['state']) 29  30             loss = criterion(winner, example['winner'], \ 31                             probas, example['move']) 32             loss.backward() 33             optimizer.step() 34  35             ## Fetch new games 36             if total_ite % REFRESH_TICK == 0: 37                 last_id = fetch_new_games(collection, dataset, last_id) 

训练用的损失函数表示如下:

 1 class AlphaLoss(torch.nn.Module):  2     def __init__(self):  3         super(AlphaLoss, self).__init__()  4   5    def forward(self, pred_winner, winner, pred_probas, probas):  6        value_error = (winner - pred_winner) ** 2  7        policy_error = torch.sum((-probas *   8                                (1e-6 + pred_probas).log()), 1)  9        total_error = (value_error.view(-1) + policy_error).mean() 10        return total_error

三是评估 (Evaluation) ,看训练过的智能体,比起正在生成数据的智能体,是不是更优秀了 (最优秀者回到第一步,继续生成数据) 。

 1 def evaluate(player, new_player):  2     results = play(player, opponent=new_player)  3     black_wins = 0  4     white_wins = 0  5   6     for result in results:  7         if result[0] == 1:  8             white_wins += 1  9         elif result[0] == 0: 10             black_wins += 1 11 12     ## Check if the trained player (black) is better than 13     ## the current best player depending on the threshold 14     if black_wins >= EVAL_THRESH * len(results): 15         return True 16     return False

第三部分很重要,要不断选出最优的网络,来不断生成高质量的数据,才能提升AI的棋艺。

三个环节周而复始,才能养成强大的棋手。

年幼的SuperGo

小笛用学校的服务器训练了AI棋手一星期

SuperGo还年幼,是在9x9棋盘上训练的。

小笛说,他的AI现在好像还不懂生死一类的事,但应该已经知道围棋是个抢地盘的游戏了。

虽然,没有训练出什么超神的棋手,但这次尝试依然值得庆祝。

Reddit上面,也有同仁发来贺电。
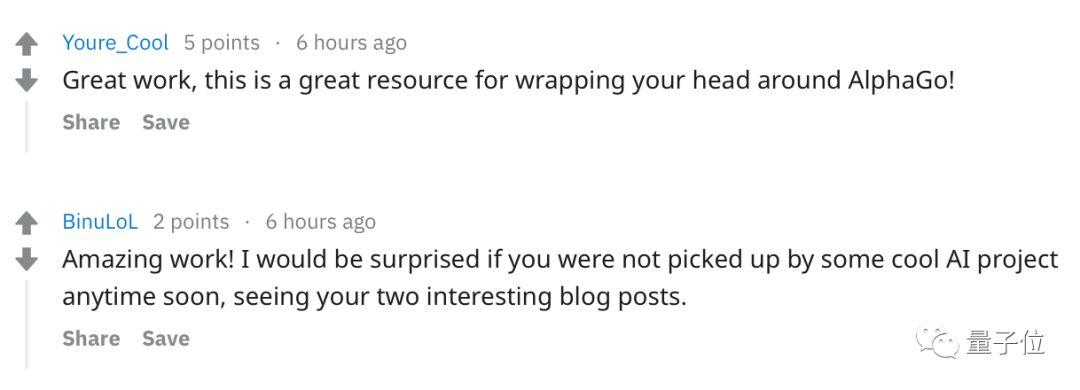
有志于AI围棋的各位,可以试一试这个PyTorch实现。

你可能没有5000个TPU,也没有Leela Zero作者的一呼百应技能,不过梦想还是可以有的。

代码实现传送门:https://ift.tt/2vxoV3L

教程原文传送门:https://ift.tt/2n1n1Vd

AlphaGo Zero论文传送门:https://ift.tt/2yztrBO

最后一句

昨天 (8月2日) ,是柯洁的生日。
欢迎大家关注我们的专栏:量子位 - 知乎专栏

诚挚招聘

量子位正在招募编辑/记者,工作地点在北京中关村。期待有才气、有热情的同学加入我们!相关细节,请在量子位公众号(QbitAI)对话界面,回复"招聘"两个字。

量子位 QbitAI· 头条号签约作者

վ'ᴗ' ի 追踪AI技术和产品新动态


via 量子位 - 知乎专栏 https://ift.tt/2LQLStS
RSS Feed

RSS5

IFTTT

DeepSeek + Pi 王炸组合跑赢 Claude Code?-InfoQ每周精要No.935

「每周精要」 ...