2018年8月3日星期五

AlphaGo Zero你也造一只,此处有PyTorch实现

原作 Dylan Djian栗子棋 编译整理量子位 出品 | 公众号 QbitAI
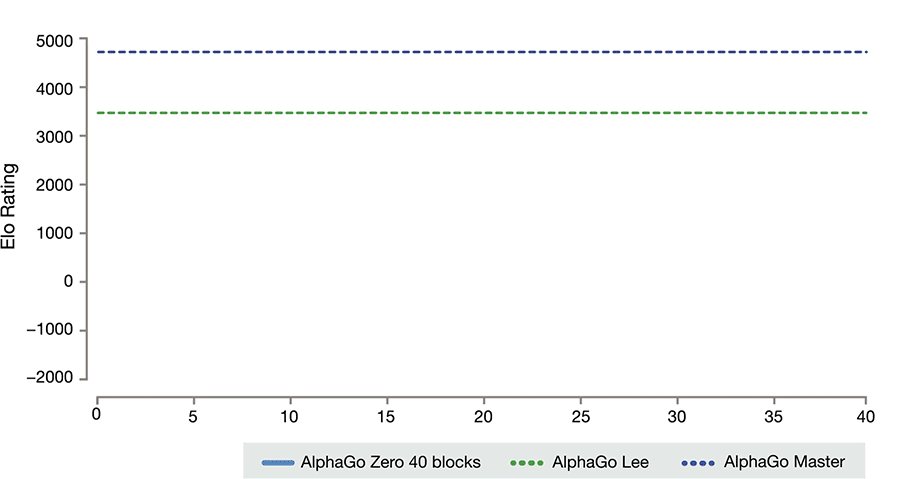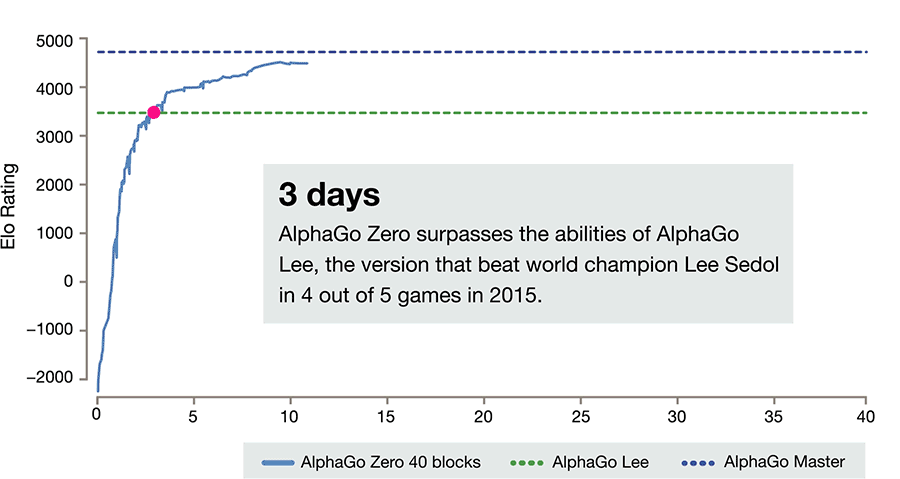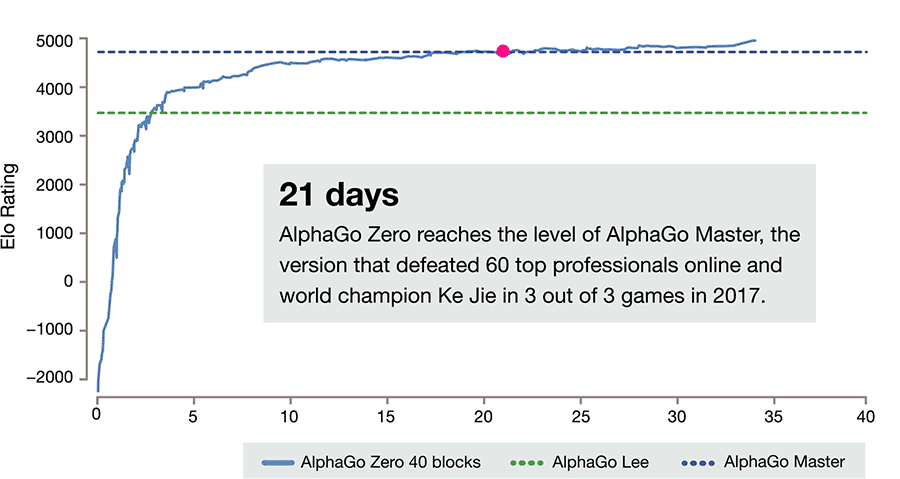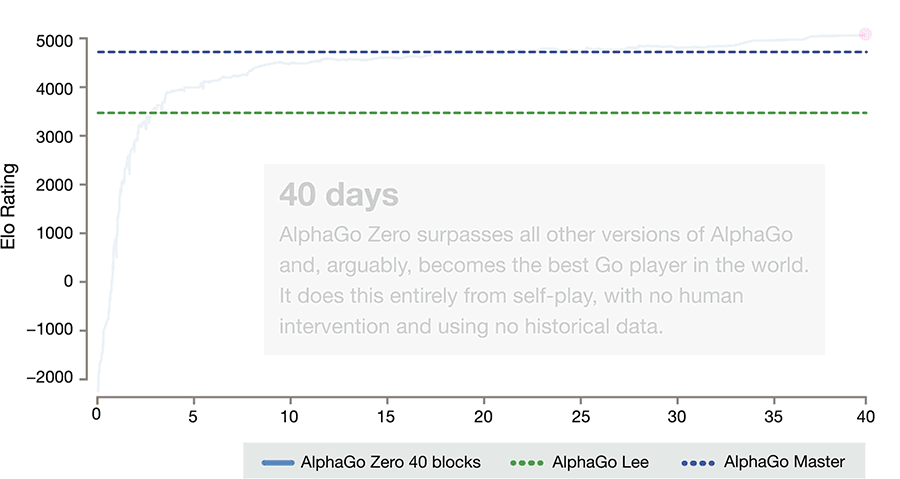
遥想当年,AlphaGo的Master版本,在完胜柯洁九段之后不久,就被后辈AlphaGo Zero (简称狗零) 击溃了。

从一只完全不懂围棋的AI,到打败Master,狗零只用了21天

而且,它不需要用人类知识来喂养,成为顶尖棋手全靠自学

如果能培育这样一只AI,即便自己不会下棋,也可以很骄傲吧。

于是,来自巴黎的少年Dylan Djian (简称小笛) ,就照着自己对狗零论文的理解,用PyTorch实现了一下。
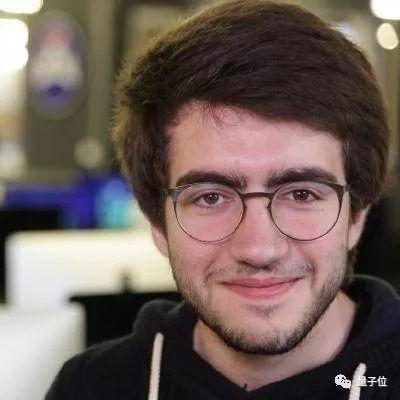
他给自己的AI棋手起名SuperGo,也提供了代码 (传送门见文底) 。

除此之外,还有教程——

一个身子两个头

智能体分成三个部分:

一是特征提取器 (Feature Extractor) ,二是策略网络 (Policy Network) ,三是价值网络 (Value Network) 。

于是,狗零也被亲切地称为"双头怪"。特征提取器是身子,其他两个网络是脑子

特征提取器

特征提取模型,是个残差网络 (ResNet) ,就是给普通CNN加上了跳层连接 (Skip Connection) , 让梯度的传播更加通畅。
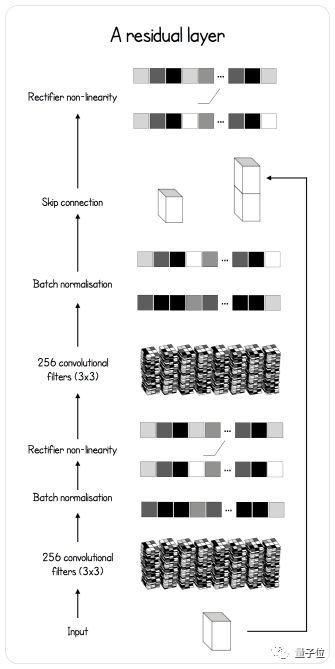
跳跃的样子,写成代码就是:

 1 class BasicBlock(nn.Module):  2     """  3     Basic residual block with 2 convolutions and a skip connection  4     before the last ReLU activation.  5     """   6  7     def __init__(self, inplanes, planes, stride=1, downsample=None):  8         super(BasicBlock, self).__init__()  9 10         self.conv1 = nn.Conv2d(inplanes, planes, kernel_size=3, 11                         stride=stride, padding=1, bias=False) 12         self.bn1 = nn.BatchNorm2d(planes) 13 14         self.conv2 = nn.Conv2d(planes, planes, kernel_size=3, 15                         stride=stride, padding=1, bias=False) 16         self.bn2 = nn.BatchNorm2d(planes) 17 18 19     def forward(self, x): 20         residual = x 21 22         out = self.conv1(x) 23         out = F.relu(self.bn1(out)) 24 25         out = self.conv2(out) 26         out = self.bn2(out) 27 28         out += residual 29         out = F.relu(out) 30 31         return out

然后,把它加到特征提取模型里面去:

 1 class Extractor(nn.Module):  2     def __init__(self, inplanes, outplanes):  3         super(Extractor, self).__init__()  4         self.conv1 = nn.Conv2d(inplanes, outplanes, stride=1,  5                         kernel_size=3, padding=1, bias=False)  6         self.bn1 = nn.BatchNorm2d(outplanes)  7   8         for block in range(BLOCKS):  9             setattr(self, "res{}".format(block), \ 10                 BasicBlock(outplanes, outplanes)) 11 12 13     def forward(self, x): 14         x = F.relu(self.bn1(self.conv1(x))) 15         for block in range(BLOCKS - 1): 16             x = getattr(self, "res{}".format(block))(x) 17 18         feature_maps = getattr(self, "res{}".format(BLOCKS - 1))(x) 19         return feature_maps

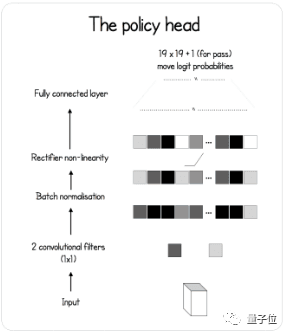
策略网络

策略网络就是普通的CNN了,里面有个批量标准化 (Batch Normalization) ,还有一个全连接层,输出概率分布

 1 class PolicyNet(nn.Module):  2     def __init__(self, inplanes, outplanes):  3         super(PolicyNet, self).__init__()  4         self.outplanes = outplanes  5         self.conv = nn.Conv2d(inplanes, 1, kernel_size=1)  6         self.bn = nn.BatchNorm2d(1)  7         self.logsoftmax = nn.LogSoftmax(dim=1)  8         self.fc = nn.Linear(outplanes - 1, outplanes)  9 10 11     def forward(self, x): 12         x = F.relu(self.bn(self.conv(x))) 13         x = x.view(-1, self.outplanes - 1) 14         x = self.fc(x) 15         probas = self.logsoftmax(x).exp() 16 17         return probas

价值网络

这个网络稍微复杂一点。除了标配之外,还要再多加一个全连接层。最后,用双曲正切 (Hyperbolic Tangent) 算出 (-1,1) 之间的数值,来表示当前状态下的赢面多大。
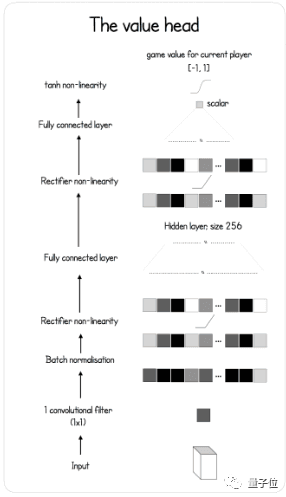
代码长这样——

 1 class ValueNet(nn.Module):  2     def __init__(self, inplanes, outplanes):  3         super(ValueNet, self).__init__()  4         self.outplanes = outplanes  5         self.conv = nn.Conv2d(inplanes, 1, kernel_size=1)  6         self.bn = nn.BatchNorm2d(1)  7         self.fc1 = nn.Linear(outplanes - 1, 256)  8         self.fc2 = nn.Linear(256, 1)  9  10  11     def forward(self, x): 12         x = F.relu(self.bn(self.conv(x))) 13         x = x.view(-1, self.outplanes - 1) 14         x = F.relu(self.fc1(x)) 15         winning = F.tanh(self.fc2(x)) 16         return winning

未雨绸缪的树

狗零,还有一个很重要的组成部分,就是蒙特卡洛树搜索 (MCTS) 。

它可以让AI棋手提前找出,胜率最高的落子点。

在模拟器里,模拟对方的下一手,以及再下一手,给出应对之策,所以提前的远不止是一步

节点 (Node)

树上的每一个节点,都代表一种不同的局势,有不同的统计数据:

每个节点被经过的次数n,总动作值w,经过这一点的先验概率p,平均动作值q (q=w/n) ,还有从别处来到这个节点走的那一步,以及从这个节点出发、所有可能的下一步

1 class Node: 2     def __init__(self, parent=None, proba=None, move=None): 3         self.p = proba 4         self.n = 0 5         self.w = 0 6         self.q = 0 7         self.children = [] 8         self.parent = parent 9         self.move = move

部署 (Rollout)

第一步是PUCT (多项式上置信树) 算法,选择能让PUCT函数 (下图) 的某个变体 (Variant) 最大化,的走法。
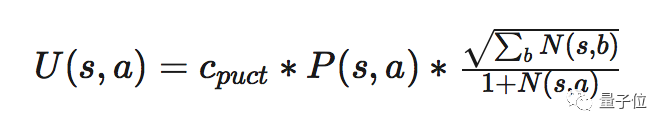
写成代码的话——

 1 def select(nodes, c_puct=C_PUCT):  2     " Optimized version of the selection based of the PUCT formula "  3   4     total_count = 0  5     for i in range(nodes.shape[0]):  6         total_count += nodes[i][1]  7  8     action_scores = np.zeros(nodes.shape[0])  9     for i in range(nodes.shape[0]): 10         action_scores[i] = nodes[i][0] + c_puct * nodes[i][2] * \ 11                 (np.sqrt(total_count) / (1 + nodes[i][1])) 12  13     equals = np.where(action_scores == np.max(action_scores))[0] 14     if equals.shape[0] > 0: 15         return np.random.choice(equals) 16     return equals[0]

结束 (Ending)

选择在不停地进行,直至到达一个叶节点 (Leaf Node) ,而这个节点还没有往下生枝。

1 def is_leaf(self): 2     """ Check whether a node is a leaf or not """ 3  4     return len(self.children) == 0

到了叶节点,那里的一个随机状态就会被评估,得出所有"下一步"的概率。

所有被禁的落子点,概率会变成零,然后重新把总概率归为1。

然后,这个叶节点就会生出枝节 (都是可以落子的位置,概率不为零的那些) 。代码如下——

1 def expand(self, probas): 2     self.children = [Node(parent=self, move=idx, proba=probas[idx]) \ 3                 for idx in range(probas.shape[0]) if probas[idx] > 0]

更新一下

枝节生好之后,这个叶节点和它的妈妈们,身上的统计数据都会更新,用的是下面这两串代码。

1 def update(self, v): 2     """ Update the node statistics after a rollout """ 3  4     self.w = self.w + v 5     self.q = self.w / self.n if self.n > 0 else 0 1 while current_node.parent: 2     current_node.update(v) 3     current_node = current_node.parent

选择落子点

模拟器搭好了,每个可能的"下一步",都有了自己的统计数据。

按照这些数据,算法会选择其中一步,真要落子的地方。

选择有两种,一就是选择被模拟的次数最多的点。试用于测试和实战。

另外一种,随机 (Stochastically) 选择,把节点被经过的次数转换成概率分布,用的是以下代码——

1 total = np.sum(action_scores) 2 probas = action_scores / total 3 move = np.random.choice(action_scores.shape[0], p=probas)

后者适用于训练,让AlphaGo探索更多可能的选择。

三位一体的修炼

狗零的修炼分为三个过程,是异步的。

一是自对弈 (Self-Play) ,用来生成数据。

 1 def self_play():  2     while True:  3         new_player, checkpoint = load_player()  4         if new_player:  5             player = new_player  6   7         ## Create the self-play match queue of processes  8         results = create_matches(player, cores=PARALLEL_SELF_PLAY,  9                                          match_number=SELF_PLAY_MATCH)  10         for _ in range(SELF_PLAY_MATCH): 11             result = results.get() 12             db.insert({ 13                 "game": result, 14                 "id": game_id 15             }) 16             game_id += 1

二是训练 (Training) ,拿新鲜生成的数据,来改进当前的神经网络。

 1 def train():  2     criterion = AlphaLoss()  3     dataset = SelfPlayDataset()  4     player, checkpoint = load_player(current_time, loaded_version)   5     optimizer = create_optimizer(player, lr,  6                                     param=checkpoint['optimizer'])  7     best_player = deepcopy(player)  8     dataloader = DataLoader(dataset, collate_fn=collate_fn, \  9                 batch_size=BATCH_SIZE, shuffle=True) 10  11     while True: 12         for batch_idx, (state, move, winner) in enumerate(dataloader): 13  14             ## Evaluate a copy of the current network 15             if total_ite % TRAIN_STEPS == 0: 16                 pending_player = deepcopy(player) 17                 result = evaluate(pending_player, best_player) 18  19                 if result: 20                     best_player = pending_player 21  22             example = { 23                 'state': state, 24                 'winner': winner, 25                 'move' : move 26             } 27             optimizer.zero_grad() 28             winner, probas = pending_player.predict(example['state']) 29  30             loss = criterion(winner, example['winner'], \ 31                             probas, example['move']) 32             loss.backward() 33             optimizer.step() 34  35             ## Fetch new games 36             if total_ite % REFRESH_TICK == 0: 37                 last_id = fetch_new_games(collection, dataset, last_id) 

训练用的损失函数表示如下:

 1 class AlphaLoss(torch.nn.Module):  2     def __init__(self):  3         super(AlphaLoss, self).__init__()  4   5    def forward(self, pred_winner, winner, pred_probas, probas):  6        value_error = (winner - pred_winner) ** 2  7        policy_error = torch.sum((-probas *   8                                (1e-6 + pred_probas).log()), 1)  9        total_error = (value_error.view(-1) + policy_error).mean() 10        return total_error

三是评估 (Evaluation) ,看训练过的智能体,比起正在生成数据的智能体,是不是更优秀了 (最优秀者回到第一步,继续生成数据) 。

 1 def evaluate(player, new_player):  2     results = play(player, opponent=new_player)  3     black_wins = 0  4     white_wins = 0  5   6     for result in results:  7         if result[0] == 1:  8             white_wins += 1  9         elif result[0] == 0: 10             black_wins += 1 11 12     ## Check if the trained player (black) is better than 13     ## the current best player depending on the threshold 14     if black_wins >= EVAL_THRESH * len(results): 15         return True 16     return False

第三部分很重要,要不断选出最优的网络,来不断生成高质量的数据,才能提升AI的棋艺。

三个环节周而复始,才能养成强大的棋手。

年幼的SuperGo

小笛用学校的服务器训练了AI棋手一星期

SuperGo还年幼,是在9x9棋盘上训练的。

小笛说,他的AI现在好像还不懂生死一类的事,但应该已经知道围棋是个抢地盘的游戏了。

虽然,没有训练出什么超神的棋手,但这次尝试依然值得庆祝。

Reddit上面,也有同仁发来贺电。
有志于AI围棋的各位,可以试一试这个PyTorch实现。

你可能没有5000个TPU,也没有Leela Zero作者的一呼百应技能,不过梦想还是可以有的。

代码实现传送门:https://ift.tt/2vxoV3L

教程原文传送门:https://ift.tt/2n1n1Vd

AlphaGo Zero论文传送门:https://ift.tt/2yztrBO

最后一句

昨天 (8月2日) ,是柯洁的生日。
欢迎大家关注我们的专栏:量子位 - 知乎专栏

诚挚招聘

量子位正在招募编辑/记者,工作地点在北京中关村。期待有才气、有热情的同学加入我们!相关细节,请在量子位公众号(QbitAI)对话界面,回复"招聘"两个字。

量子位 QbitAI· 头条号签约作者

վ'ᴗ' ի 追踪AI技术和产品新动态


via 量子位 - 知乎专栏 https://ift.tt/2LQLStS
RSS Feed

RSS5

IFTTT

AlphaGo Zero你也造一只,此处有PyTorch实现

原作 Dylan Djian栗子棋 编译整理量子位 出品 | 公众号 QbitAI

遥想当年,AlphaGo的Master版本,在完胜柯洁九段之后不久,就被后辈AlphaGo Zero (简称狗零) 击溃了。

从一只完全不懂围棋的AI,到打败Master,狗零只用了21天

而且,它不需要用人类知识来喂养,成为顶尖棋手全靠自学

如果能培育这样一只AI,即便自己不会下棋,也可以很骄傲吧。

于是,来自巴黎的少年Dylan Djian (简称小笛) ,就照着自己对狗零论文的理解,用PyTorch实现了一下。

他给自己的AI棋手起名SuperGo,也提供了代码 (传送门见文底) 。

除此之外,还有教程——

一个身子两个头

智能体分成三个部分:

一是特征提取器 (Feature Extractor) ,二是策略网络 (Policy Network) ,三是价值网络 (Value Network) 。

于是,狗零也被亲切地称为"双头怪"。特征提取器是身子,其他两个网络是脑子

特征提取器

特征提取模型,是个残差网络 (ResNet) ,就是给普通CNN加上了跳层连接 (Skip Connection) , 让梯度的传播更加通畅。

跳跃的样子,写成代码就是:

 1 class BasicBlock(nn.Module):  2     """  3     Basic residual block with 2 convolutions and a skip connection  4     before the last ReLU activation.  5     """   6  7     def __init__(self, inplanes, planes, stride=1, downsample=None):  8         super(BasicBlock, self).__init__()  9 10         self.conv1 = nn.Conv2d(inplanes, planes, kernel_size=3, 11                         stride=stride, padding=1, bias=False) 12         self.bn1 = nn.BatchNorm2d(planes) 13 14         self.conv2 = nn.Conv2d(planes, planes, kernel_size=3, 15                         stride=stride, padding=1, bias=False) 16         self.bn2 = nn.BatchNorm2d(planes) 17 18 19     def forward(self, x): 20         residual = x 21 22         out = self.conv1(x) 23         out = F.relu(self.bn1(out)) 24 25         out = self.conv2(out) 26         out = self.bn2(out) 27 28         out += residual 29         out = F.relu(out) 30 31         return out

然后,把它加到特征提取模型里面去:

 1 class Extractor(nn.Module):  2     def __init__(self, inplanes, outplanes):  3         super(Extractor, self).__init__()  4         self.conv1 = nn.Conv2d(inplanes, outplanes, stride=1,  5                         kernel_size=3, padding=1, bias=False)  6         self.bn1 = nn.BatchNorm2d(outplanes)  7   8         for block in range(BLOCKS):  9             setattr(self, "res{}".format(block), \ 10                 BasicBlock(outplanes, outplanes)) 11 12 13     def forward(self, x): 14         x = F.relu(self.bn1(self.conv1(x))) 15         for block in range(BLOCKS - 1): 16             x = getattr(self, "res{}".format(block))(x) 17 18         feature_maps = getattr(self, "res{}".format(BLOCKS - 1))(x) 19         return feature_maps

策略网络

策略网络就是普通的CNN了,里面有个批量标准化 (Batch Normalization) ,还有一个全连接层,输出概率分布

 1 class PolicyNet(nn.Module):  2     def __init__(self, inplanes, outplanes):  3         super(PolicyNet, self).__init__()  4         self.outplanes = outplanes  5         self.conv = nn.Conv2d(inplanes, 1, kernel_size=1)  6         self.bn = nn.BatchNorm2d(1)  7         self.logsoftmax = nn.LogSoftmax(dim=1)  8         self.fc = nn.Linear(outplanes - 1, outplanes)  9 10 11     def forward(self, x): 12         x = F.relu(self.bn(self.conv(x))) 13         x = x.view(-1, self.outplanes - 1) 14         x = self.fc(x) 15         probas = self.logsoftmax(x).exp() 16 17         return probas

价值网络

这个网络稍微复杂一点。除了标配之外,还要再多加一个全连接层。最后,用双曲正切 (Hyperbolic Tangent) 算出 (-1,1) 之间的数值,来表示当前状态下的赢面多大。

代码长这样——

 1 class ValueNet(nn.Module):  2     def __init__(self, inplanes, outplanes):  3         super(ValueNet, self).__init__()  4         self.outplanes = outplanes  5         self.conv = nn.Conv2d(inplanes, 1, kernel_size=1)  6         self.bn = nn.BatchNorm2d(1)  7         self.fc1 = nn.Linear(outplanes - 1, 256)  8         self.fc2 = nn.Linear(256, 1)  9  10  11     def forward(self, x): 12         x = F.relu(self.bn(self.conv(x))) 13         x = x.view(-1, self.outplanes - 1) 14         x = F.relu(self.fc1(x)) 15         winning = F.tanh(self.fc2(x)) 16         return winning

未雨绸缪的树

狗零,还有一个很重要的组成部分,就是蒙特卡洛树搜索 (MCTS) 。

它可以让AI棋手提前找出,胜率最高的落子点。

在模拟器里,模拟对方的下一手,以及再下一手,给出应对之策,所以提前的远不止是一步

节点 (Node)

树上的每一个节点,都代表一种不同的局势,有不同的统计数据:

每个节点被经过的次数n,总动作值w,经过这一点的先验概率p,平均动作值q (q=w/n) ,还有从别处来到这个节点走的那一步,以及从这个节点出发、所有可能的下一步

1 class Node: 2     def __init__(self, parent=None, proba=None, move=None): 3         self.p = proba 4         self.n = 0 5         self.w = 0 6         self.q = 0 7         self.children = [] 8         self.parent = parent 9         self.move = move

部署 (Rollout)

第一步是PUCT (多项式上置信树) 算法,选择能让PUCT函数 (下图) 的某个变体 (Variant) 最大化,的走法。

写成代码的话——

 1 def select(nodes, c_puct=C_PUCT):  2     " Optimized version of the selection based of the PUCT formula "  3   4     total_count = 0  5     for i in range(nodes.shape[0]):  6         total_count += nodes[i][1]  7  8     action_scores = np.zeros(nodes.shape[0])  9     for i in range(nodes.shape[0]): 10         action_scores[i] = nodes[i][0] + c_puct * nodes[i][2] * \ 11                 (np.sqrt(total_count) / (1 + nodes[i][1])) 12  13     equals = np.where(action_scores == np.max(action_scores))[0] 14     if equals.shape[0] > 0: 15         return np.random.choice(equals) 16     return equals[0]

结束 (Ending)

选择在不停地进行,直至到达一个叶节点 (Leaf Node) ,而这个节点还没有往下生枝。

1 def is_leaf(self): 2     """ Check whether a node is a leaf or not """ 3  4     return len(self.children) == 0

到了叶节点,那里的一个随机状态就会被评估,得出所有"下一步"的概率。

所有被禁的落子点,概率会变成零,然后重新把总概率归为1。

然后,这个叶节点就会生出枝节 (都是可以落子的位置,概率不为零的那些) 。代码如下——

1 def expand(self, probas): 2     self.children = [Node(parent=self, move=idx, proba=probas[idx]) \ 3                 for idx in range(probas.shape[0]) if probas[idx] > 0]

更新一下

枝节生好之后,这个叶节点和它的妈妈们,身上的统计数据都会更新,用的是下面这两串代码。

1 def update(self, v): 2     """ Update the node statistics after a rollout """ 3  4     self.w = self.w + v 5     self.q = self.w / self.n if self.n > 0 else 0 1 while current_node.parent: 2     current_node.update(v) 3     current_node = current_node.parent

选择落子点

模拟器搭好了,每个可能的"下一步",都有了自己的统计数据。

按照这些数据,算法会选择其中一步,真要落子的地方。

选择有两种,一就是选择被模拟的次数最多的点。试用于测试和实战。

另外一种,随机 (Stochastically) 选择,把节点被经过的次数转换成概率分布,用的是以下代码——

1 total = np.sum(action_scores) 2 probas = action_scores / total 3 move = np.random.choice(action_scores.shape[0], p=probas)

后者适用于训练,让AlphaGo探索更多可能的选择。

三位一体的修炼

狗零的修炼分为三个过程,是异步的。

一是自对弈 (Self-Play) ,用来生成数据。

 1 def self_play():  2     while True:  3         new_player, checkpoint = load_player()  4         if new_player:  5             player = new_player  6   7         ## Create the self-play match queue of processes  8         results = create_matches(player, cores=PARALLEL_SELF_PLAY,  9                                          match_number=SELF_PLAY_MATCH)  10         for _ in range(SELF_PLAY_MATCH): 11             result = results.get() 12             db.insert({ 13                 "game": result, 14                 "id": game_id 15             }) 16             game_id += 1

二是训练 (Training) ,拿新鲜生成的数据,来改进当前的神经网络。

 1 def train():  2     criterion = AlphaLoss()  3     dataset = SelfPlayDataset()  4     player, checkpoint = load_player(current_time, loaded_version)   5     optimizer = create_optimizer(player, lr,  6                                     param=checkpoint['optimizer'])  7     best_player = deepcopy(player)  8     dataloader = DataLoader(dataset, collate_fn=collate_fn, \  9                 batch_size=BATCH_SIZE, shuffle=True) 10  11     while True: 12         for batch_idx, (state, move, winner) in enumerate(dataloader): 13  14             ## Evaluate a copy of the current network 15             if total_ite % TRAIN_STEPS == 0: 16                 pending_player = deepcopy(player) 17                 result = evaluate(pending_player, best_player) 18  19                 if result: 20                     best_player = pending_player 21  22             example = { 23                 'state': state, 24                 'winner': winner, 25                 'move' : move 26             } 27             optimizer.zero_grad() 28             winner, probas = pending_player.predict(example['state']) 29  30             loss = criterion(winner, example['winner'], \ 31                             probas, example['move']) 32             loss.backward() 33             optimizer.step() 34  35             ## Fetch new games 36             if total_ite % REFRESH_TICK == 0: 37                 last_id = fetch_new_games(collection, dataset, last_id) 

训练用的损失函数表示如下:

 1 class AlphaLoss(torch.nn.Module):  2     def __init__(self):  3         super(AlphaLoss, self).__init__()  4   5    def forward(self, pred_winner, winner, pred_probas, probas):  6        value_error = (winner - pred_winner) ** 2  7        policy_error = torch.sum((-probas *   8                                (1e-6 + pred_probas).log()), 1)  9        total_error = (value_error.view(-1) + policy_error).mean() 10        return total_error

三是评估 (Evaluation) ,看训练过的智能体,比起正在生成数据的智能体,是不是更优秀了 (最优秀者回到第一步,继续生成数据) 。

 1 def evaluate(player, new_player):  2     results = play(player, opponent=new_player)  3     black_wins = 0  4     white_wins = 0  5   6     for result in results:  7         if result[0] == 1:  8             white_wins += 1  9         elif result[0] == 0: 10             black_wins += 1 11 12     ## Check if the trained player (black) is better than 13     ## the current best player depending on the threshold 14     if black_wins >= EVAL_THRESH * len(results): 15         return True 16     return False

第三部分很重要,要不断选出最优的网络,来不断生成高质量的数据,才能提升AI的棋艺。

三个环节周而复始,才能养成强大的棋手。

年幼的SuperGo

小笛用学校的服务器训练了AI棋手一星期

SuperGo还年幼,是在9x9棋盘上训练的。

小笛说,他的AI现在好像还不懂生死一类的事,但应该已经知道围棋是个抢地盘的游戏了。

虽然,没有训练出什么超神的棋手,但这次尝试依然值得庆祝。

Reddit上面,也有同仁发来贺电。

有志于AI围棋的各位,可以试一试这个PyTorch实现。

你可能没有5000个TPU,也没有Leela Zero作者的一呼百应技能,不过梦想还是可以有的。

代码实现传送门:https://ift.tt/2vxoV3L

教程原文传送门:https://ift.tt/2n1n1Vd

AlphaGo Zero论文传送门:https://ift.tt/2yztrBO

最后一句

昨天 (8月2日) ,是柯洁的生日。

欢迎大家关注我们的专栏:量子位 - 知乎专栏

诚挚招聘

量子位正在招募编辑/记者,工作地点在北京中关村。期待有才气、有热情的同学加入我们!相关细节,请在量子位公众号(QbitAI)对话界面,回复"招聘"两个字。

量子位 QbitAI· 头条号签约作者

վ'ᴗ' ի 追踪AI技术和产品新动态


via 量子位 - 知乎专栏 https://ift.tt/2LQLStS
RSS Feed

RSS5

IFTTT

开源的“谷歌AutoML杀手”来了 | Auto Keras

夏乙 发自 凹非寺量子位 出品 | 公众号 QbitAI

让神经网络自己设计神经网络,大降机器学习门槛的Google AutoML,最近终于开始了Beta测试。

不过,很快就有同行纷纷跳出来表示不服。最新的一波来自美国德州农工大学(Texas A&M University)助理教授胡侠和他的两名博士生:金海峰、Qingquan Song。

下图从左到右,依次就是他们三位:

他们不仅吐槽了Google AutoML的问题,还给出了自己的解决方案:Auto-Keras,一个基于Keras的开源自动机器学习Python软件库。

胡老师和学生们所列出的Google AutoML三大缺陷,简单来说是这样的:

🙄 第一,还得付钱。🙄 第二,因为在云上,还得配置Docker容器和Kubernetes。🙄 第三,服务商(Google)保证不了你数据安全和隐私。

机器学习博客Towards Data Science上的一篇文章,给了个更加直接的评价:太疯狂了!以前Google和整个AI界都更喜欢开源,喜欢和所有人分享知识,现在竟然拿这个东西来赚钱?

于是,这篇文章认定,Google AutoML会败于开源,而德州农工的Auto-Keras,将成为AutoML杀手。

Auto-Keras是一个开源、免费的工具,和Google的AutoML功能相似,也能为深度学习模型自动搜索架构和超参数,使用的方法是高效神经架构搜索(Efficient Neural Architecture Search,简称ENAS)。

其实,ENAS方法来源于Google Brain,是AutoML团队今年2月提出的。胡侠和同学们在打造Auto-Keras的时候,对ENAS做了一些改造。

原来的ENAS基于参数共享,而Auto-Keras所用的,则是基于网络态射(network morphism)。

他们为了降低ENAS的计算成本,引入神经网络核和树结构的采集函数优化算法,用贝叶斯优化来引导神经网络的网络态射。这样可以在改变神经架构的同时保持神经网络的功能,在搜索期间提高训练效率。

想尝试一下?安装也很简单:

pip install autokeras

完成。

在众多深度学习框架中,Keras是以简单好上手著称的,所以,Auto-Keras的代码也不难理解,想要在它基础上做一些个性化设置,可以自己调整参数。

用到最后,还能看到神经架构搜索得出的模型。

最后,附上一些传送门 ↓

官网:

https://autokeras.com/

GitHub:

jhfjhfj1/autokeras

论文:jhfjhfj1/autokeras论文:

Efficient Neural Architecture Search with Network MorphismHaifeng Jin, Qingquan Song, Xia Huhttps://arxiv.org/abs/1806.10282

enjoy~

—欢迎大家关注我们的专栏:量子位 - 知乎专栏诚挚招聘量子位正在招募编辑/记者,工作地点在北京中关村。期待有才气、有热情的同学加入我们!相关细节,请在量子位公众号(QbitAI)对话界面,回复"招聘"两个字。量子位 QbitAI· 头条号签约作者վ'ᴗ' ի 追踪AI技术和产品新动态


via 量子位 - 知乎专栏 https://ift.tt/2vyZHSD
RSS Feed

RSS5

IFTTT

开源的“谷歌AutoML杀手”来了 | Auto Keras

夏乙 发自 凹非寺量子位 出品 | 公众号 QbitAI

让神经网络自己设计神经网络,大降机器学习门槛的Google AutoML,最近终于开始了Beta测试。

不过,很快就有同行纷纷跳出来表示不服。最新的一波来自美国德州农工大学(Texas A&M University)助理教授胡侠和他的两名博士生:金海峰、Qingquan Song。

下图从左到右,依次就是他们三位:

他们不仅吐槽了Google AutoML的问题,还给出了自己的解决方案:Auto-Keras,一个基于Keras的开源自动机器学习Python软件库。

胡老师和学生们所列出的Google AutoML三大缺陷,简单来说是这样的:

🙄 第一,还得付钱。🙄 第二,因为在云上,还得配置Docker容器和Kubernetes。🙄 第三,服务商(Google)保证不了你数据安全和隐私。

机器学习博客Towards Data Science上的一篇文章,给了个更加直接的评价:太疯狂了!以前Google和整个AI界都更喜欢开源,喜欢和所有人分享知识,现在竟然拿这个东西来赚钱?

于是,这篇文章认定,Google AutoML会败于开源,而德州农工的Auto-Keras,将成为AutoML杀手。

Auto-Keras是一个开源、免费的工具,和Google的AutoML功能相似,也能为深度学习模型自动搜索架构和超参数,使用的方法是高效神经架构搜索(Efficient Neural Architecture Search,简称ENAS)。

其实,ENAS方法来源于Google Brain,是AutoML团队今年2月提出的。胡侠和同学们在打造Auto-Keras的时候,对ENAS做了一些改造。

原来的ENAS基于参数共享,而Auto-Keras所用的,则是基于网络态射(network morphism)。

他们为了降低ENAS的计算成本,引入神经网络核和树结构的采集函数优化算法,用贝叶斯优化来引导神经网络的网络态射。这样可以在改变神经架构的同时保持神经网络的功能,在搜索期间提高训练效率。

想尝试一下?安装也很简单:

pip install autokeras

完成。

在众多深度学习框架中,Keras是以简单好上手著称的,所以,Auto-Keras的代码也不难理解,想要在它基础上做一些个性化设置,可以自己调整参数。

用到最后,还能看到神经架构搜索得出的模型。

最后,附上一些传送门 ↓

官网:

https://autokeras.com/

GitHub:

jhfjhfj1/autokeras

论文:jhfjhfj1/autokeras论文:

Efficient Neural Architecture Search with Network MorphismHaifeng Jin, Qingquan Song, Xia Huhttps://arxiv.org/abs/1806.10282

enjoy~

—欢迎大家关注我们的专栏:量子位 - 知乎专栏诚挚招聘量子位正在招募编辑/记者,工作地点在北京中关村。期待有才气、有热情的同学加入我们!相关细节,请在量子位公众号(QbitAI)对话界面,回复"招聘"两个字。量子位 QbitAI· 头条号签约作者վ'ᴗ' ի 追踪AI技术和产品新动态


via 量子位 - 知乎专栏 https://ift.tt/2vyZHSD
RSS Feed

RSS5

IFTTT

ECCV 2018 | 腾讯AI Lab解读19篇入选论文

计算机视觉欧洲大会(European Conference on Computer Vision,简称ECCV)将于9月8日-14日在德国慕尼黑举办,该会议与CVPR、ICCV共称为计算机视觉领域三大顶级学术会议,每年录用论文约300篇。

今年是腾讯AI Lab第二次参加ECCV,共有19篇文章入选,以下为摘要解读。

在近期结束的多个顶会中,腾讯AI Lab还有多篇论文入选,位居国内企业前列,包括ACL 2018 (5篇)ICML 2018(16篇)CVPR 2018(21篇)和此前的NIPS 2017(8篇)

1.针对基于优化的视觉惯导里程计的动态传感器延时建模

Modeling Varying Camera-IMU Time Offset in Optimization-Based Visual-Inertial Odometry

该论文由腾讯AI Lab独立完成。由于相机和IMU(惯导测量单元)这两种传感器提供的信息对于运动估计具有很强的互补性,所以把这两种传感器信息融合在一起用于运动估计被学界证实是很有效的。然而,过去大部分的相机和IMU融合方法都是假设使用了全局快门相机和同步的传感器测量。这个假设在现实情况下往往是不成立的。因为在大部分的消费电子产品里,装配的往往是卷帘快门相机和非同步的传感器测量。为了解决这个问题,本文提出了一种基于非线性优化的单目视觉惯导融合方法。这种方法对相机和IMU之间的延时进行建模,并把其当作一个可动态变化的量。本文提出的这种方法可以统一处理使用卷帘快门相机带来的图像失真问题和非同步的传感器测量问题。同时,为了加速优化过程中所需要的可变长度IMU测量积分,本文提出了一种基于动态规划和红黑树的高效计算方法。最后,为了提高单目视觉惯导融合方法的鲁棒性,本文提出了一种对传感器噪声建模的初始化方法。本文在Euroc数据集和手机采集的数据中和目前最好的方法进行了对比。实验结果表明,本文提出的方法是非常有效的。

2.面向跨年龄人脸识别的正交深度特征分解

Orthogonal Deep Features Decomposition for Age-Invariant Face Recognition

该论文由腾讯AI Lab独立完成。由于年龄变化会导致人的外貌产生显著变化,所以跨年龄人脸识别依旧是人脸识别领域的一项重要挑战。为了减少年龄变化导致的类内差异,本文提出了一种称为正交嵌入CNN(Orthogonal Embedding CNNs, OE-CNNs)的新框架来学习对年龄变化具有鲁棒性的深度人脸特征。具体而言,本文将深度人脸特征分解为两个正交的分量,分别表示与年龄信息相关的分量以及与身份信息相关的分量。通过剥离与年龄信息相关的分量,所得到的身份信息特征便可用于精准的跨年龄人脸识别。此外,为了补充现有的跨年龄人脸数据的不足并推进该领域的学术研究,本文还构建了一个全新的跨年龄人脸数据集(Cross-Age Face Datset, CAF)。研究者在国际著名的跨年龄人脸识别数据集MORPH Album 2,CACD-VS,FG-NET上进行了实验评估,验证了所提出的方法的有效性。最后,研究者在通用人脸识别数据集LFW上也做了实验,验证了本文提出的方法对于通用人脸识别也有很好的泛化性。

3.针对图像自动描述的递归融合网络

Recurrent Fusion Network for Image Captioning

该论文由腾讯AI Lab主导,与复旦大学合作完成。最近,图像的自动描述已经取得了很大进展,所有最先进的模型都采用了编码器-解码器框架。在此框架下,输入图像由卷积神经网络(CNN)编码,然后通过递归神经网络(RNN)转换为自然语言。依赖于该框架的现有模型仅使用一种CNN(例如ResNet或Inception-X)来描述图像内容。因此,不能全面地理解输入图像的语义含义,这限制了描述质量的提高。在本文中,为了利用来自多个编码器的互补信息,提出了一种用于图像的自动描述任务的递归融合网络(RFNet)。该模型的融合过程可以利用CNN输出的特征之间的相互关系,来为解码器生成新的更富含信息的图像表示。MSCOCO数据集上的实验结果证明了本文提出的RFNet的有效性,它是图像自动描述领域中一种新的SOTA技术。

4.基于堆叠式循环一致性生成对抗网络的无间监督图像到图像转换

Unsupervised Image-to-Image Translation with Stacked Cycle-Consistent Adversarial Networks

该论文由腾讯AI Lab主导,与复旦大学合作完成。最近关于无监督的图像到图像转换研究取得了较为显著的进展,其主要是通过训练一对具有循环一致性损失(cycle-consistent loss)的生成对抗网络Generative Adversarial Networks)。然而,当图像分辨率高或者两个图像域具有显着差异时(例如 Cityscapes 数据集中图像语义分割与城市景观照片之间的转换),这种无监督方法可能产生较差的结果。在本文中,通过把单个转换分解为多阶段转换,提出了堆叠循环一致性对抗网络(SCAN)。其通过学习低分辨率图像到图像的转换,然后基于低分辨率的转换学习更高分辨率的转换,这样做提高了图像转换质量并且使得学习高分辨率转换成为可能。此外,为了适当地利用来自前一阶段的学习到的信息,研究者设计了自适应融合块以学习当前阶段的输出和前一阶段的输出的动态整合。在多个数据集的实验表明,与以前的单阶段方法相比,本文提出的方法可以大大提高图像到图像转换的质量。

5.基于神经网络的双目图像风格转移

Neural Stereoscopic Image Style Transfer

该论文由腾讯AI Lab主导,与电子科技大学合作完成。神经风格转移是一种新兴技术,能够赋予普通图像以极具吸引力的艺术风格。现有的工作已经成功的应用卷积神经网络(CNN)来对2D图像或视频进行风格转移。然而,双目3D图像的风格转移仍然缺乏相应的研究工作。与2D图像不同,对双目3D图像进行风格转移的时候需要保留输入图片的深度信息,否则生成的风格化双目3D图像的立体感会被严重地破坏。在本文中,研究者构建了一个新颖的双路径网络,双目3D图像的每张图片都是在单独的路径中处理。该网络能够在对双目3D图片进行风格转移的同时,保留输入图片的深度信息。除了使用传统的感知损失来控制生成图片的风格化质量外,研究者提出了多层视角损失函数,能够有效的保留输入图片的深度信息。此外,研究者还提出了一个特征聚合模块,该模块能够有效地共享两条路径之间的特征信息,在多层视角损失函数的监督下,该模块能够进一步保留输入图片的深度信息。实验结果表明,与以前的方法相比,该网络不仅能够实现优秀的风格转移效果,还能够很好的保持原图的深度信息。

6.视频再定位

Video Re-localization

该论文由腾讯AI Lab主导,与罗彻斯特大学合作完成。目前,视频检索领域已经发展的很成熟,但是这个领域当中还有一些未解决的问题。例如,给定一个查询视频,如何在一个长的备选视频当中找到与查询视频语义相关的片段?本文定义了一种名叫视频重定位(video re-localization)的新任务来解决这样的问题。视频重定位有广泛的应用价值,例如它可以用于视频片段定位、拷贝检测、视频监控等。同时,视频重定位也是一种很难解决的任务,因为语义相关的视频,可能看起来非常不同。要解决视频重定位问题,第一个难点就是没有相关的视频数据集。收集和标注语义相关的视频,是一项非常费时费力的工作。因此,研究者重新组织了ActivityNet数据集中的视频,用于视频重定位的研究。然后,本文提出了一种cross gating的双线性匹配(bilinear matching)模型,用来匹配查询视频和备选视频。最后,研究者用分类的方式,来预测相关片段的起始点和终止点。实验证明,本文提出的方法要优于相应的基线模型。

7.针对人脸超分辨率的超身份同一性卷积神经网络模型

Super-Identity Convolutional Neural Network for Face Hallucination

该论文由腾讯AI Lab与香港中文大学、德克萨斯州大学奥斯汀分校等合作完成。人脸超分辨率是解决利用低分辨率人脸图像生成高分辨率人脸图像的生成式任务,同时需要考虑到人的面部感观非常依赖身份信息。然而,先前的人脸超分辨率方法忽略了对面部身份信息的恢复。本文提出了超身份同一性卷积神经网络(SICNN)来恢复身份同一性,以便于生成接近真实身份的超分辨率人脸图像。具体地,研究者在超球面的身份度量空间定义一个超身份同一性损失,用于衡量生成图像和真实高分辨率图像的身份差异性。然而,直接使用这个损失将导致动态域不收敛问题,这是由真实高分辨率域与生成高分辨率域之间存在的较大间隔引起的。为了克服这一挑战,研究者提出了一个通过在这两个域之间构建鲁棒的身份度量约束的训练方法。大量的实验评估证明,相比之前最先进的方法,在具有挑战性的对12x14的人脸图像进行8倍超分辨率任务上,本文提出的SICNN方法取得了更优越的超分辨率可视效果。此外,SICNN方法显著提高了极低分辨率人脸图像的可识别性。

8.Bi-Real网络:具有更强表达能力的1-比特卷积神经网络及一种先进训练算法

Bi-Real Net: Enhancing the Performance of 1-bit CNNs with Improved Representational Capability and Advanced Training Algorithm

该论文由腾讯AI Lab与香港科技大学、华中科技大学合作完成。本文研究了1-比特卷积神经网络,也即网络参数激活函数输出都是二值化。相对于标准的实数化网络,1-比特网络在存储空间和计算复杂度上具有很大的优势,但是其分类性能还相距甚远。为了缩小1-比特网络和实数化网络的性能差距,本文提出了一种新的1-比特网络,名为Bi-Real网络。其基本思想是通过一个残差结构,将网络训练过程中产生的实数化输出(即1-比特卷积层的输出,Sign激活函数的输入)与下一模块的输出结合,大幅度提高了网络的表征潜力,且没有增加额外的计算成本。为了更好地挖掘出Bi-Real网络的表征潜力,本文提出了全新的训练算法,包括三个具体的创新点:1)设计对Sign激活函数的更紧致可导估计函数;2)利用参数幅值相关的梯度来更新参数;3)设计更合适的实数化网络对Bi-Real网络进行初始化。本工作以残差神经网络为主干网络,设计了两种不同深度的Bi-Real网络,分别为18层和34层,并在ImageNet数据集上进行了测试,它们分别取得了56.4%和62.2%的top-1识别精度。相较于当前最先进的1-比特网络(即XNOR网络),Bi-Real网络取得了10%以上的相对精度提高。

9.基于多样性和随机性的图聚类方法的增量多图匹配

Incremental Multi-graph Matching via Diversity and Randomness based Graph Clustering

该论文由腾讯AI Lab与上海交通大学、亚利桑那州立大学合作完成。多图匹配涉及在多个图结构之间找到对应关系,现有方法主要通过一次性匹配全量的方式来求解该问题。然而,实际应用中,往往需要应对不断新增的图样本。这一需求促使本文提出了一个增量式的多图在线匹配方法。具体而言,通过分组内的样本多样性,我们对图样本进行分组,每次新的样本被归入某一分组,进行在线匹配,并将信息在不同分组间传递与更新。实验证明,我们的在线匹配方法在不明显牺牲精度的情形下,显著提高了计算效率。

10.Pixel2Mesh: 从单帧RGB图像生成三维网孔模型

Pixel2Mesh: Generating 3D Mesh Models from Single RGB Images

该论文由腾讯AI Lab与复旦大学、普林斯顿大学、Intel Labs合作完成。本文提出了一种端到端的深度学习框架,可从单张彩色图片直接生成3D mesh。受深度神经网络特性的限制,以前的方法通常用volume或者point cloud表示三维形状,将它们转换为更易于使用的mesh并非易事。与现有方法不同,本文使用图卷积神经网络表示3D mesh,利用从输入图像中提取的特征逐步对椭球进行变形从而产生正确的几何形状。本文使用由粗到精的模式进行生成,使得整个变形过程更加稳定。此外,本文还定义了几种与mesh相关的损失函数捕捉不同级别的特性,以保证视觉上有吸引力并且物理上高重建精度。大量实验表明,本文的方法不仅定性上可以生成细节更加充分的mesh模型,而且定量上与当前最好的方法相比也实现了更高的重建精度。

11.针对行人重识别的姿态归一化的图像生成方法

Pose-Normalized Image Generation for Person Re-identification

该论文由腾讯AI Lab与复旦大学、伦敦玛丽皇后大学等合作完成。行人重识别问题通常面临两大主要的挑战:(1) 缺乏大量出现在多个监控视频下的行人训练数据;(2)需求在巨大姿态变化的数据中训练学习到对身份信息敏感、且具有视角不变性的特征。在本论文工作中,提出了一个全新的深度图像生成模型,通过生成逼真的特定姿态下的行人图片来解决上述两个难点。该模型基于对抗生成网络(GAN)进行改进,实现行人重识别问题中的行人姿态归一化目标,由此本文命名为姿态归一化对抗生成网络(PN-GAN)。具体地,研究者利用姿态归一化对抗生成网络生成额外不同姿态的行人图片,从中学习到一种新的具有姿态不变性的行人特征。大量实验结果表明该特征可以很好的与原始行人图片特征形成互补,从而提升行人重识别任务的准确度。更重要的是,在本论文中,考虑并提出了一种更具真实适用性的无监督学习问题,并且通过实验证明该模型在该问题下具有潜在的强大的泛化能力,即对于一个全新的行人重识别数据或行人监控网络,该模型可以在不进行任何微调训练的前提下取得较好的精度。

12.深入研究深度信息: 利用语意关联和关注度驱动损失函数进行单目深度估计

Look Deeper into Depth: Monocular Depth Estimation with Semantic Booster and Attention-Driven Loss

该论文由腾讯AI Lab与香港城市大学、美国伊利诺伊州大学香槟城分校合作完成。机器学习技术提升了单目图像的深度估计效果,研究者观察到在现有的训练数据中深度图像的像素值呈现出一个长尾分布。然而,大部分已有方法并未特别处理深度区域在图像中的分布不平衡问题,从而导致其模型在估计图像中远距离区域时性能受限。在本文中,研究者调研了长尾分布的特性,深入挖掘图像中远距离区域并提出一种由关注度驱动的损失函数来监督式的训练神经网络。除此之外,为了更好的利用图像的语义信息进行单目深度估计,研究者提出了一个协同网络从而自动的学习这两个任务的共通性。在关注度驱动的损失函数和协同网络的共同作用下,图像的深度估计和语义标注性能得到了相互提升。研究者在挑战性的室内数据库进行了实验,其结果表明本文提出的方法在单目深度估计和语义标注任务中取得了最优的效果。

13.针对语义分割和单目深度预测的联合任务递归学习

Joint Task-Recursive Learning for Semantic Segmentation and Depth Estimation

该论文由腾讯AI Lab与南京理工大学合作完成。本文提出了一种全新的联合任务递归学习的框架,用于联合解决语义分割和单目深度预测问题。该模型能依靠序列化的任务级别的相互作用递归地改善两个任务的结果。为了两个任务能相互促进,研究者将它们的相互作用嵌入到任务注意力模块(TAM)来自适应地增强两个任务的对应相关的模式特征。而且,为了让预测更可信,研究者通过显式连接之前的响应,将两个任务过去的学习经历传播到下一次网络预测。任务级别的相互作用序列最终演化成从粗到细的尺度递变,这样所需要的细节信息能够渐进式地重建出来。在NYU depth v2和SUN RGB-D两个数据集上的实验结果表明本文提出的方法能够取得最前沿的单目深度预测和图像语义分割结果。

14.模块化生成对抗网络

Modular Generative Adversarial Networks

该论文由腾讯AI Lab与英属哥伦比亚大学合作完成。现有多领域图像变换方法尝试用一个单一模型取得映射结果。然而,这些方法的可扩展性和鲁棒性有限。受模块网络启发,本文提出了一种含有多个可重复利用且兼容模块的多领域图像变换模型ModularGAN,来实现不同功能的图像变换。这些模块可同时训练,并且可以根据图像变换涉及的领域被选择来联合使用以组建不同结构的网络。这赋予ModularGAN优异的可扩展性用以变换图像到任意希望的领域。实验结果显示,该模型不仅展现出引人注目的视觉效果,并且能在多领域脸部特征迁移的任务上超过现有最优的方法。

15.基于单张图片的人像虚化效果生成

Rendering Portraitures from Monocular Camera and Beyond

该论文由腾讯AI Lab与清华大学、加州大学默赛德分校、英伟达合作完成。浅景深是摄影的一种艺术效果,通常需要单镜头反光相机和某些摄影技巧来产生这样的效果。最近,手机的双镜头被用来估计场景的深度,并模拟了肖像拍摄的效果。然而,这种技术不能应用到已经拍摄的照片上,而且对于拍摄对象与摄像机距离很近的人像拍摄应用中。本文中,提出了一种全自动方法实现单目照相机的肖像渲染。具体地,研究者首先利用卷积神经网络来估计一个输入图像的相对深度和肖像分割图。由于来自单张图片的初始分割结果通常较为粗糙且缺少细节,因此研究者进一步学习相邻像素间的相互关系来改进分割结果。通过改进的分割估计和深度结果,研究者利用条件随机场和抠像技术对图像进行模糊渲染。另外,研究者训练了空间变换的递归神经网络来加速渲染过程。大量实验验证,本文提出的方法相对现有方法具有更好的人像虚化效果。

16. 面向目标检测任务的深度特征金字塔再组合

Deep Feature Pyramid Reconfiguration for Object Detection

该论文由腾讯AI Lab与清华大学合作完成。目前最好的目标检测器大多通过特征金字塔来学习多尺度表示从而取得更高的检测精度。然而,当前特征金字塔的设计在如何整合不同尺度的语义信息方面仍然不够高效。为此,本文在调研当前主流特征金字塔方法的基础上把特征金字塔转换为特征的再组合过程,创造性地提出了一种高度非线性但是计算快速的结构将底层表示和高层语义特征进行整合。具体而言,该网络由两个模块组成:全局注意力和局部再组合。这两个模块分布能全局和局部地去在不同的空间和尺度上提取任务相关的特征。重要的是,这两个模块具有轻量级、可嵌入和可端到端训练的优点。在基于SSD的框架上,该模型取得里比原始模型及其他变体方法明显更好的检测精度,而且没有牺牲实时的处理速度。

17.弱监督下的区域提名网络和目标检测

Weakly Supervised Region Proposal Network and Object Detection

该论文由腾讯AI Lab与华中科技大学、德州大学阿灵顿分校、约翰斯·霍普金斯大学合作完成。基于卷积网络的区域提名生成方法(RPN)通过边框标注进行训练,是当前全监督目标检测器一个核心部分。然而弱监督目标检测器因为缺乏边框标注,所以没有得益于基于CNN的提名生成方法,而只能依赖传统的提名生成方法,例如选择性搜索法。这篇文章提出了一种只利用图片级的标注的区域提名网络,该网络由两个步骤组成。第一个步骤是通过探寻卷积网络的低层信息来评价滑动窗口的目标显著性;第二个步骤利用基于区域的卷积分类器来修正第一阶段所生成的提名边框。本文提出的网络适用于弱监督目标检测,可以嵌入到任意弱监督检测器,并共享卷积计算。在PASCAL VOC和ImageNet的检测数据集上的实验表明,此方法比其他弱监督检测方法高大约3%的平均识别率。

18.局部多样性要有多局部?以动态基础集合强化行列式点过程以及在有监督视频摘要中的应用

How Local is the Local Diversity? Reinforcing Sequential Determinantal Point Processes with Dynamic Ground Sets for Supervised Video Summarization

该论文由腾讯AI Lab与中佛罗里达大学、爱荷华大学合作完成。大量的视频内容和高观看频率呼唤自动的视频摘要算法,而这些算法的一个关键属性是能够对多样性建模。如果视频长达数小时——比如第一视角的视频一般都很冗长,则有必要对视频的局部多样性建模。局部多样性指的是对短时间片段的摘要是有多样性的,但是如果一些片段在视频中出现时间相距很远,则允许它们同时出现在摘要中——即使它们看起来相似。在本文中,提出了一种基于行列式点过程(SeqDPP)的新的概率模型,用于动态控制视频片段的时间跨度,并在该视频片段上施加局部多样性。研究者使SeqDPP能够主动学习如何从输入视频中推断局部多样性的局部范围。由此产生的模型对最大似然估计(MLE)类型的训练方法提出极大的挑战,同时也受到暴露偏差和不可微分的评估指标的影响。为了解决这些问题,研究者设计了一种强化学习算法来训练提出的模型。大量实验验证了该模型和新的学习算法优于以前的方法,尤其明显优于基于MLE的方法。

19.提高行列式点过程以及在有监督视频摘要中的应用

Improving Sequential Determinantal Point Processes for Supervised Video Summarization

该论文由腾讯AI Lab与中佛罗里达大学、麻省理工学院、爱荷华大学合作完成。现在制作视频比以往任何时候都容易。无处不在的视频数据已经成为信息发现和提取的重要来源,但计算的挑战也是无与伦比的。自动视频摘要已成为浏览、搜索、和索引可视内容的重要需求。本文采用时序行列式点过程(SeqDPPs)进行有监督的视频摘要,通过概率分布对多样性进行建模。研究者从两方面改进了这个模型。在学习方面,提出了一种大间距算法来解决SeqDPP中的暴露偏差问题。在建模方面,设计了一个新的概率分布,当它被集成到SeqDPP时,最终模型允许用户输入对摘要的期望长度。此外,还显著拓展了现有的视频摘要数据库:1)加入更多的第一视角的视频,2)收集高密度的用户注释,以及3)提高评估方案。研究者用该数据集进行了大量实验(总共约60小时的视频),并将该方法与几个现有方法进行了比较。

]]> 原文: https://ift.tt/2vgRQcW
RSS Feed

机器知心

IFTTT

DeepSeek + Pi 王炸组合跑赢 Claude Code?-InfoQ每周精要No.935

「每周精要」 ...